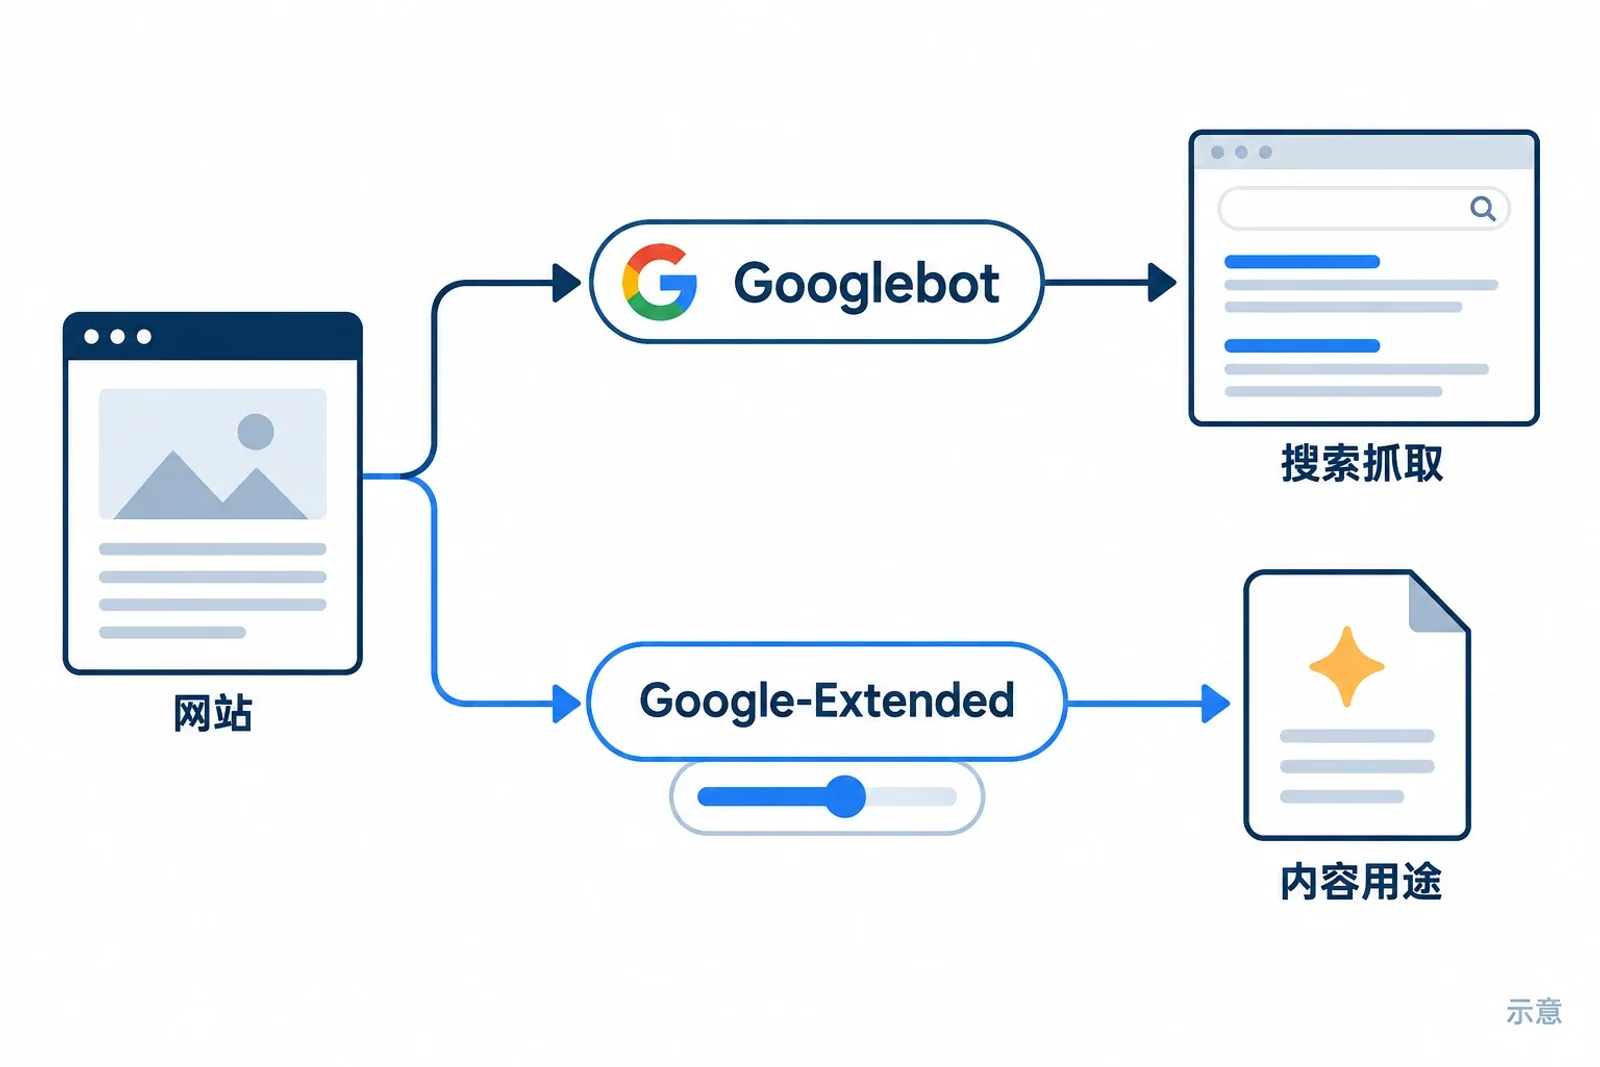
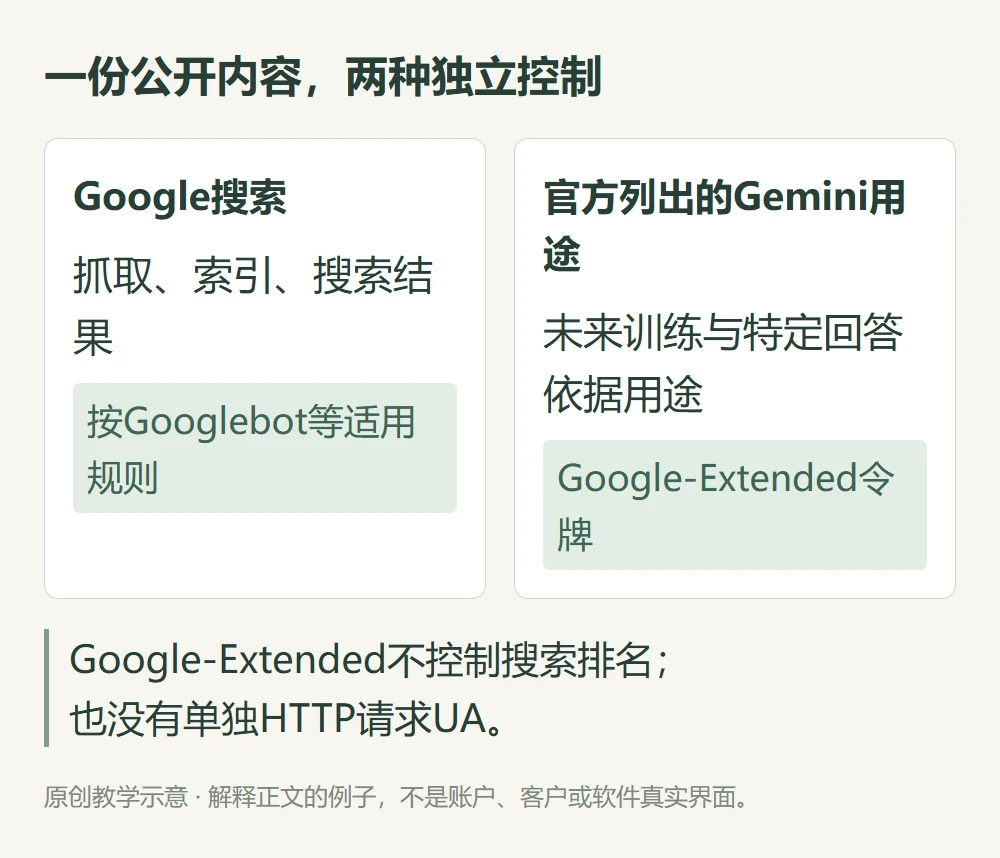
要限制网站内容用于Google说明的特定Gemini训练与回答依据用途,同时保留Google搜索抓取,可以在现有robots.txt中单独设置Google-Extended。它是内容使用控制令牌,没有独立的HTTP请求用户代理;Google明确表示,该设置不影响网站被纳入搜索,也不作为搜索排名信号。Google-Extended官方说明
实施时最关键的不是把两行代码加进去,而是确认三件事:限制的是哪种用途,覆盖哪些真实URL,以及是否意外改变Googlebot的规则。 本文路径均为说明示例,需要按网站实际文件合并,不能直接覆盖现有robots.txt。
先把内容用途与网页访问分开
当前Google-Extended说明涉及未来Gemini模型训练,以及指定Gemini应用与Vertex AI中的grounding。后者是在生成回答时提供检索内容作依据。因此,把它理解为“只控制训练”并不完整。
Googlebot负责搜索抓取;Google-Extended借助已有抓取基础设施表达后续用途选择。若目标是管理搜索内生成式AI功能的参与,应另看Search Console搜索AI内容控制,不能用一个令牌替代所有产品设置。
可以先给内容作具体安排:公开安装说明继续供用户搜索,授权目录限制上述Gemini用途,客户文件则通过登录或文件权限管理。最后一类不应依赖robots.txt保密,因为文件本身公开,网页访问也不因写入一条规则自动被服务器拒绝。
整站限制,只改对应分组
如果已经决定限制该主机下全部内容用于Google-Extended覆盖的用途,片段是:
User-agent: Google-Extended
Disallow: /
把它作为独立分组加入现有文件,并检查是否已经有Google-Extended规则。保留原来确有用途的其他抓取配置和Sitemap地址,不要只留下这个片段。
尤其注意不要把Googlebot与Google-Extended两个User-agent紧挨着写在同一组,再给它们共同设置Disallow: /。这种写法会让禁止规则同时指向两者。若业务目标只是限制Google-Extended用途,就不应把搜索抓取也放进同一组限制。
另一种容易忽略的情况,是原来已经存在Googlebot专用规则。这时不要为了显得“完整”再补一个通用允许片段。先整理实际分组,确认原有搜索抓取要求,再做最小范围修改。
只限制一部分资料,要按真实路径写
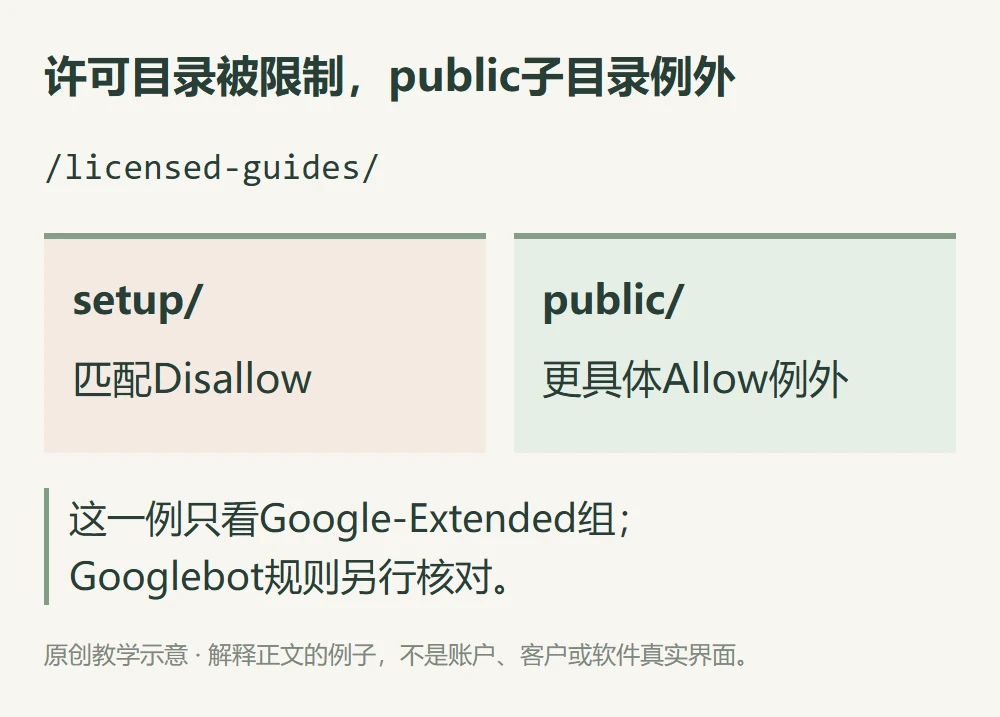
假设需要限制/licensed-guides/目录,但其中/licensed-guides/public/明确允许,可使用下面的示例:
User-agent: Google-Extended
Disallow: /licensed-guides/
Allow: /licensed-guides/public/
这里较具体的公开子目录构成例外。下面按该片段演算,前提是没有其他相关规则影响结果:
| 实际路径 | 本片段的结果 | 原因 |
|---|---|---|
/licensed-guides/setup/ | 限制 | 位于限制目录下 |
/licensed-guides/public/sample/ | 允许 | 命中更具体的允许路径 |
/licensed-guides-2026/setup/ | 未被该片段限制 | 路径不在带斜杠的同一目录 |
/Licensed-Guides/setup/ | 未被该片段限制 | 路径大小写不同 |
/licensed-guides | 未被该片段限制 | 没有末尾斜杠,不匹配此目录前缀 |
若最后一个地址会跳转到带斜杠版本,应分别了解原地址和最终地址,而不是忽略它。验收列表应从真实URL取得,不从后台分类名称推测。WordPress把文章归入某分类,不代表文章固定链接就位于同名目录。
Google按匹配分组与路径规则解析,不是“文件最后一行覆盖前面”。相同用户代理的多个具体组会合并,而具体组与通用*组不会这样叠加;路径还存在具体程度和冲突处理规则。复杂文件应对照Google的robots.txt规范检查完整结果。
因此,增加一条独立Google-Extended组后,不要想当然地认为它同时继承了所有*组中的目录限制。若这些限制也是本次内容使用选择的一部分,应在实际配置中明确核对。
合并后,用同一组URL分别核对两种用途
下面把片段放回一份完整的教学文件。假设原文件只有Googlebot对/internal/的限制,以及一条地图声明;本次也不允许internal内容用于Google-Extended,并限制授权资料目录,保留public例外。示例路径和地图均须按实际站点核对,不是让你覆盖原文件中的其他有效分组。
User-agent: Googlebot
Disallow: /internal/

User-agent: Google-Extended
Disallow: /internal/
Disallow: /licensed-guides/
Allow: /licensed-guides/public/

Sitemap: https://example.com/sitemap.xml
这里Googlebot组保持原样,Google-Extended组独立表达内容使用安排。按这份文件推导同一组路径,结果如下;它不是Google后台实际处理记录:
| 样本路径 | Googlebot抓取许可 | Google-Extended所涵盖用途 |
|---|---|---|
/licensed-guides/setup/ | 允许 | 限制 |
/licensed-guides/public/sample/ | 允许 | 允许 |
/internal/draft/ | 限制 | 限制 |
/articles/start/ | 允许 | 允许 |
第一行就是本次希望获得的区别:搜索抓取仍可进行,指定内容用途受到限制。第三行在两个组各写一次,是明确安排,不靠其中一组继承另一组。这里的“允许”只表示这些robots规则没有限制该路径,登录、索引指令等条件仍各自生效。
将自己完整文件中的组和真实路径代入。如果授权资料在Googlebot列也变成限制,先看两个User-agent是否误写在同一组,以及原Googlebot组是否已有相关目录限制;如果只有public例外未生效,就比较实际URL与Allow路径。这样能把错误定位到具体分组或匹配,不需要反复追加整站Allow。
WordPress后台保存后,验证公网实际返回
robots.txt可能由WordPress、SEO插件、服务器实体文件或其他配置提供。后台出现可编辑框,并不能证明外部请求正由它控制。先打开正式主机名下的/robots.txt,保存当前全文,再确认维护入口。
例如正式网址采用https://www.example.com,就从这个主机的robots.txt开始。文件作用范围与主机、协议和端口有关,主站的配置不自动覆盖另一个子域名。若资料还发布在独立文档子域名,需要把那个主机列为单独检查对象。
保存后重新请求公网文件,检查得到的是新文本,而非旧缓存、登录页面、404或安全验证页。若后台值与公网不同,先找到文件来源和缓存环节;不断重复追加规则不能解决这个差异。
公开文本确认更新后,沿用上一节的双列验收记录,填入真实URL与实际命中的规则,再补实际存在的大小写或斜杠变体。后台保存、公开文件更新、路径匹配正确,分别记录结果,避免把演示表当成已完成的上线验证。
若同一次操作还修改了SEO插件或页面设置,应另外核对索引指令。出现异常可以沿抓取与索引排查流程继续查,不能用“Google-Extended不影响搜索”来替同期所有改动作保证。
日志里没有Google-Extended,不等于设置失败
由于它没有独立HTTP请求用户代理,访问日志里找不到这个名字是不能用来判定成败的。自己发送一个带Google-Extended请求头的访问,看到网页仍能打开,也没有检查到Google内部的内容用途处理。
可直接验证的是:指定主机已发布正确文件、规则匹配目标范围、Googlebot安排没有被误改。这与证明某段内容已从过去的训练数据或模型中删除,是不同层面的结果。Google对抓取与内容使用有单独说明,内容可能在遵守用途选择的前提下复用,不能靠自己服务器的一条请求日志追踪每次内部使用。
交接时应写清实际完成的动作,例如“在某主机发布Google-Extended目录限制,检查了目标URL与例外范围,保存修改前后文本”。不要写成无法验证的“所有AI均无法使用”或“历史内容已经彻底删除”。
以后要放开,别只在末尾再加一条规则
内容授权或业务策略变化时,先读出当前完整分组,确认是否存在早先由插件、运维或其他人添加的限制。按新的目标修改对应规则,再复查目标与非目标URL。对简单配置,整理为一份明确规则通常比累积多个相反片段更好维护。
保留的记录不必复杂:变更日期、实际文件地址、内容范围、修改前后文本、负责人和验收URL。以后网站换插件、换CDN或迁移主机,可以拿这份记录检查配置是否仍在,而不用重新猜测当初为什么限制某个目录。
允许Google-Extended也只是表达内容使用选择,不保证某个Gemini回答会引用你的页面。是否限制,应基于内容授权与业务目标决定,而不是把这个设置当成确定的曝光交换条件。
常见问题
限制Google-Extended会降低Google排名吗?
Google说明该令牌不影响搜索纳入,也不作为排名信号。仍需单独确认Googlebot、页面索引指令和访问状态没有被同期改动影响。
加了目录规则,分类下所有文章都会受限制吗?
要看文章真实URL是否匹配路径。WordPress分类关系与固定链接目录未必相同,应抽取文章地址逐条核对。
用防火墙封禁名叫Google-Extended的请求可以替代吗?
它没有独立HTTP用户代理,不能把这个名称当作单独爬虫身份来实施等价封禁。应使用官方说明的robots.txt产品令牌控制相应用途。
可以只在文件末尾写Allow来取消以前的限制吗?
不能只凭位置判断。先检查同一用户代理的所有相关规则与路径匹配结果,再修改为明确的新安排,随后验证公网全文和目标URL。