产品页能打开,GSC却提示robots.txt抓取失败。你在后台加了Allow,甚至把文件改得只剩几行,提示还是没消失。问题可能发生在规则送到Google之前,继续改规则内容并不能恢复文件下载。
先请求报错主机根路径的robots.txt,记录状态、实际正文和时间。404通常按没有这份文件处理;429、服务器和网络错误则需要恢复稳定读取。修好当前输出后,再核目标页面许可与Google的读取记录,别把三个对象混成一项“已修好”。
先分清文件下载失败,还是规则不允许
假设需要读取https://shop.example.com/products/ax20/。相关文件是这个主机根路径的https://shop.example.com/robots.txt。
如果文件返回预期文本,Google取得规则后发现目标命中Disallow,那是规则许可问题。如果文件本身超时、报503或被验证页面替换,则先查文件可用性。相同的产品抓取失败现象,处理入口可能完全不同。
可以在浏览器开发者工具的Network里查看文件请求,保留最初响应、可能的跳转与最终正文;也可以请维护人员用HTTP工具读取。只在地址栏看到一段文字,还不足以确认最初请求的状态与经过的路径。
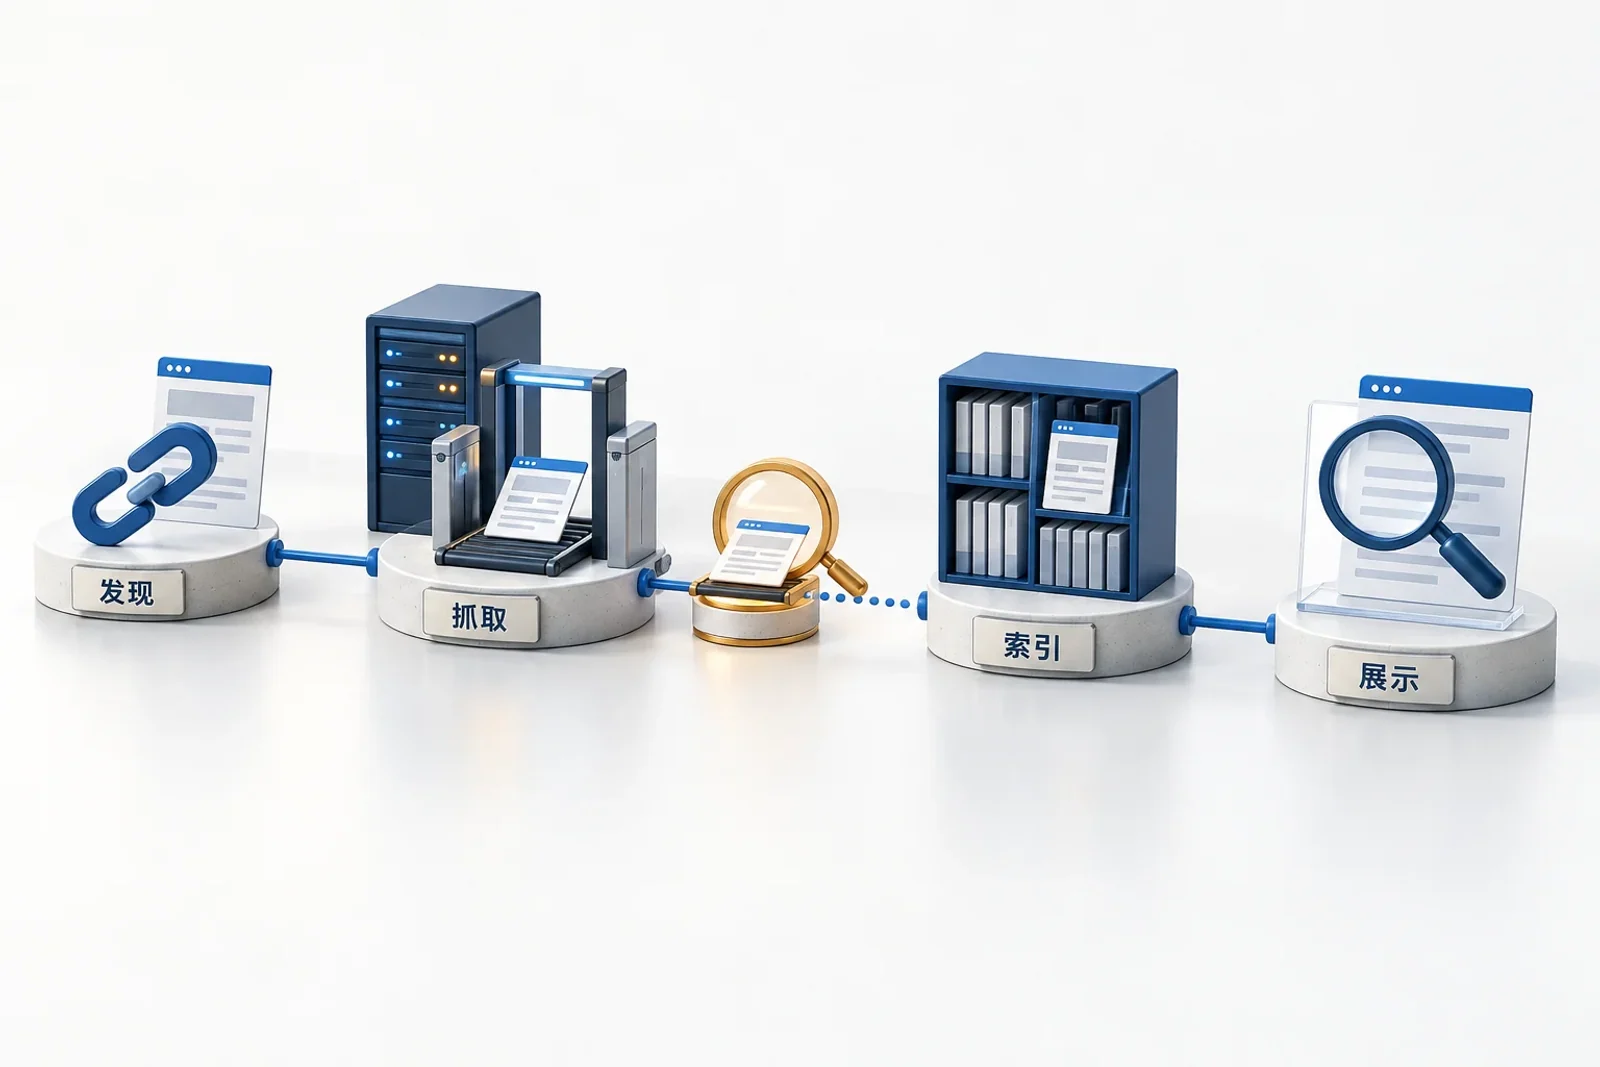
这一步只是在判断抓取前的控制文件能否取得。它不能代替产品正文测试,更不代表产品已索引。路径匹配确有问题时,再使用robots.txt写法与规则检查;不要同时重做文件、页面与全部站点设置。
404、429和服务器错误,走不同分支
Google的robots.txt规范说明对不同响应有明确处理。这里说的是Google的实现,不能自动套给所有爬虫。
| 文件请求的结果 | 对Google意味着什么 | 维护时先查什么 |
|---|---|---|
| 200与预期规则文本 | 可以读取并处理规则 | 目标路径适用哪组规则 |
| 404、410等普通4xx,429除外 | 按没有可用robots限制处理 | 是否本来需要文件及原有限制是否丢失 |
| 429 | 属于需要特殊处理的过载信号 | 限速是否误作用于文件请求 |
| 5xx | 文件无法正常提取,进入错误处理 | 主机、网关或边缘哪层报错 |
| DNS失败、超时或连接中断 | 按服务器错误处理 | 解析、网络与服务可达性 |
401或403也不能用来替代Disallow。对于这个控制文件,Google按普通4xx处理时,可能意味着你原本想保留的抓取限制不再适用。私人资料更不能靠这个文件保护,应使用实际身份验证与访问控制。
200同样要看正文。如果返回登录HTML、挑战页或错误页面,Google会尝试从可解析内容中提取规则,而不是自动得到你后台保存的完整文件。维护方应恢复明确、正确的规则输出,不能把HTML响应视为交付通过。
429也不意味着源站CPU必然满了,它可能由CDN或限流规则产生。查同一请求的返回层,才能决定是调整误限、修复服务还是处理真实容量问题。若涉及持续503,可接着看主机与错误时段的定位方法。
为什么一个主机正常,另一个仍失败
robots的范围与协议、主机和端口有关。主站的文件不能替shop.example.com证明成功,HTTPS文件的结果也不能不加核对地代替其他访问入口。
先从报错URL复制准确主机,再核它根路径的文件。如果它跳转到其他位置,记录经过哪些地址、每一步状态及最终内容。浏览器自动走完跳转,可能让最初失败或异常链条不明显。
还要确认谁负责输出。WordPress可能动态生成文件,主机根目录也可能有实体文件,CDN则可能保留旧响应。后台设置保存成功,只能证明那一处保存成功,不能证明本次公开请求由它响应。
因此,一个更可靠的维护记录是“shop主机的根路径请求,在某时刻由哪层返回什么”,而不是“我把WordPress的robots改了”。先找到产生当前输出的一层,再修改受影响对象,避免同时在三处加规则。
Google缓存规则时,故障会怎样继续
当前文件与Google已保存版本可能不同
Google通常会缓存robots内容,正常情况下缓存时间一般可到24小时;无法刷新等情形可能延长,也可能受缓存响应头影响。你刚发布新文件,不能据此推断Google已经读取新版。
这个差别不意味着只需等待。先验证你现在提供的文件确实正确、稳定,再去看Google最近的读取时间与状态。若当前仍是503,等缓存失效不会替你修复服务。
持续错误有条件分支,不是恢复承诺
按当前Google规范,遇到无法提取的服务器错误时,前12小时会停止网站抓取,同时继续尝试取得robots。若仍无法取得新版本,后续会在规范说明的30天阶段内使用上一次正常版本并重试;没有可用缓存时按相应无规则情形处理。
错误长期未修复后,还要看网站整体是否通常可访问:通常可访问和整体也存在可用性故障,后续行为不同。完整条件应以原厂错误处理与缓存说明为准。
这些数字用于解释可能发生的行为,不是网站可以停着不修的宽限期,也不是“满12小时自动恢复”或“第30天一定重新收录”。对经营者来说,有证据的当前故障应尽快处理;修复日期和Google新读取日期则分别保留。
修复之后,文件和目标页各验一次
以下用自拟案例演示,所有主机、时段与规则均为教学设定,并非真实站点的处理记录。
假设主域example.com/robots.txt返回200,但shop.example.com/robots.txt因边缘策略返回503。产品页本身暂时能开,编辑于是反复给主域文件补Allow,却没有改变shop的失败响应。
先修本次失败的文件请求
维护人员对齐shop请求与边缘事件,确认是哪条策略作用在该路径,再按实际需求调整。之后以同一协议、主机和路径重新请求,取得200和预期规则文本。
复核不能只记录“状态从503变200”,还要保存当前正文。例如本应限制内部目录的规则仍在,公开产品没有被误限;不能为了恢复读取把全部原有限制顺手删掉。
| 对象 | 修正前 | 修正后当前检查 |
|---|---|---|
| 主域robots | 200 | 仍正常,不作为shop证明 |
| shop的robots | 边缘503 | 200且规则符合约定 |
| shop产品页 | 普通浏览器可开 | 另查适用规则与当前产品正文 |
再验目标页面,最后看新读取记录
确认shop文件能读取后,检查目标产品对应的爬虫组与路径许可,并测试当前页面是否能取得正确正文。产品可能还有登录、验证码或其他限制,不能因为robots恢复就跳过这一层。
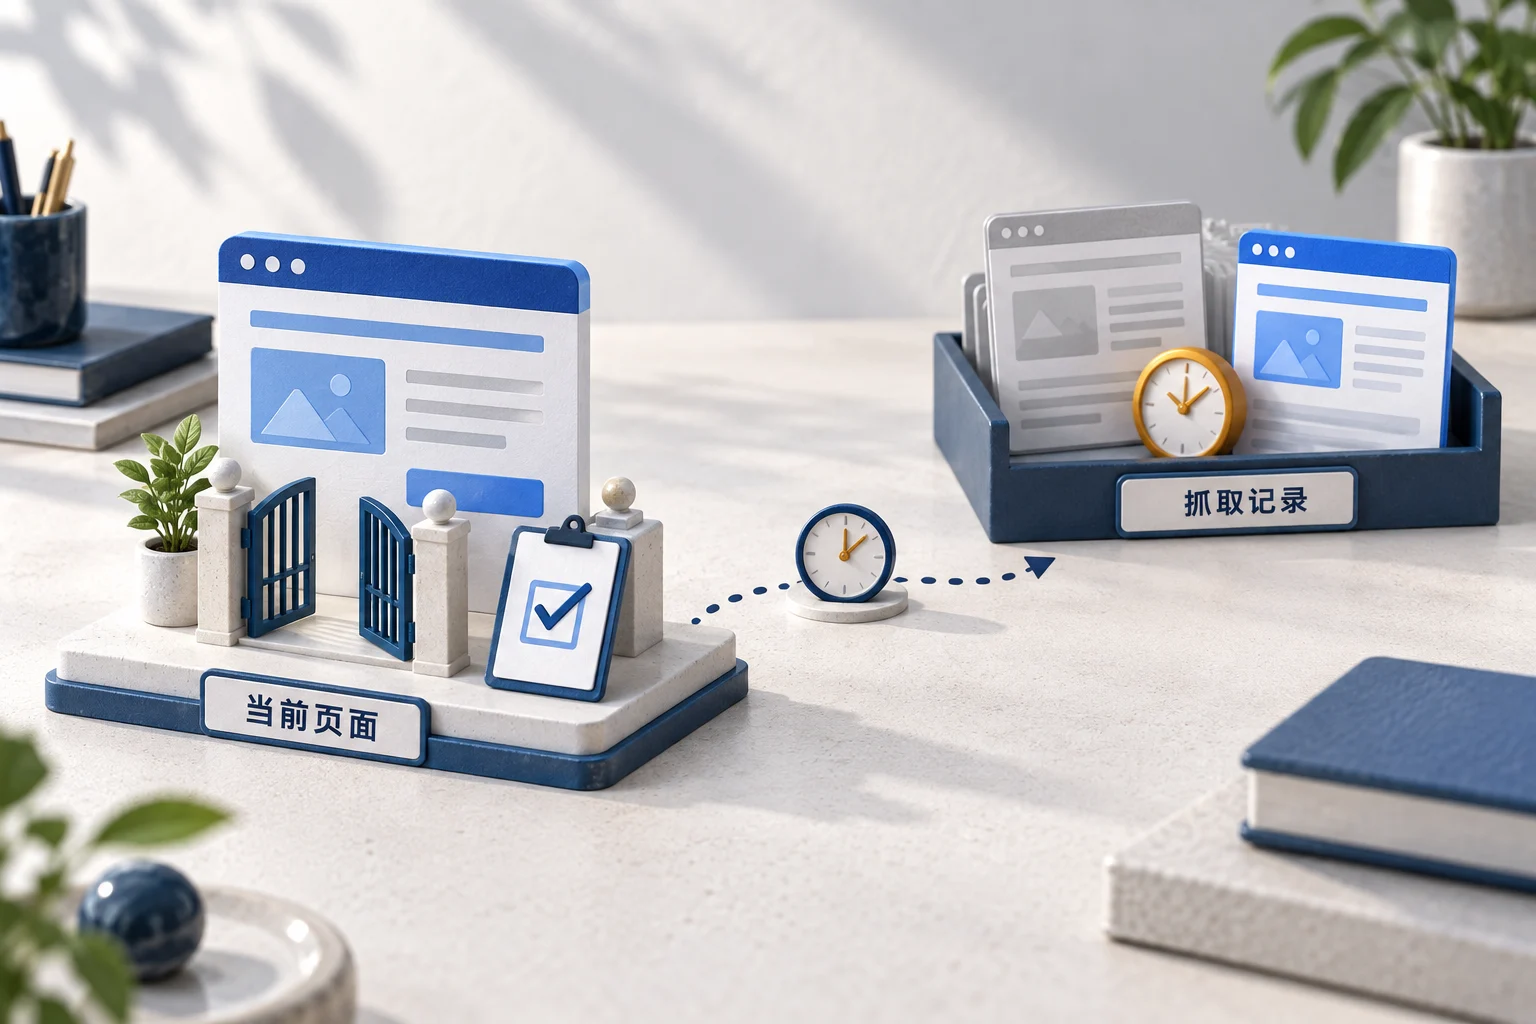
然后查看GSC能取得的robots信息、抓取统计及后续记录,区分新读取与旧错误。如果Google的最近记录仍早于修复,只能写“当前文件和目标检查通过,后续读取待确认”。抓取统计的官方说明还指出,文件不可用时,某些本来会发生却未实际发出的抓取也可能进入汇总;因此不能把总数直接当作源站日志次数。
本例一份完整的恢复记录应包括:故障主机和时间窗口、返回层与响应、调整对象、修复时间、当前文件全文、代表目标的许可及正文结果,以及Google后续读取状态。没有看到的部分明确待核,避免同事根据一句“已恢复”停止调查。
如果文件恢复后仍有特定页面问题,就转入抓取与索引总排查。继续新增Allow无法处理规范选择、薄弱内容或索引系统尚未完成的工作。
常见问题
robots抓取失败时,需要重新提交所有文章吗?
先恢复对应文件与访问输出。重复请求文章索引不能代替Google取得正确规则,反而容易让维护记录混乱。修复后对重要页面核当前情况,再按具体状态处理。
把文件删除成404,会不会更快恢复?
404通常不构成Google的全站抓取禁令,但删除也会撤掉原来用来管理路径的限制。是否需要文件取决于实际目标,不应为了改一个提示盲目删除。已有错误响应应查清生成或访问故障。
本来就没有robots.txt,必须补一份吗?
没有需要管理的抓取规则时,不必仅因为404就认定网站故障。仍要确认404确实来自预期主机与路径,以及普通页面的访问、索引设置和隐私保护各自符合需求。