robots.txt放在网站对应主机的根路径,用来告诉遵守规则的爬虫哪些网址可以抓取、哪些路径不要抓取。写法的基本单位是一组User-agent和下面的Allow、Disallow规则。修改前备份当前内容,修改后用几条具体网址检查结果,比直接套用一大段“SEO优化模板”可靠。
如果你只是希望某篇文章不出现在搜索结果里,先停在这里判断一下目标。robots.txt限制的是抓取;需要排除索引的公开页面,通常使用可被抓取的noindex标记;私人资料则应使用登录和访问控制。这三件事不能混用。Google对robots.txt用途的说明
先确认规则管的是哪个网站
检查入口应当类似https://example.com/robots.txt,文件名使用小写。放在/blog/robots.txt里的文件,不能代替主机根路径的文件。协议、主机和端口构成规则的适用范围,因此主站与shop.example.com需要分别检查,不能根据主站结果推断子域也一样。Google的范围规则
实际维护时,我建议把浏览器地址栏中的完整地址复制下来,再与需要限制的网址比较。常见的疏漏是后台修改了不带www的站点,却一直在查看另一个主机的文件。文件内容完全相同,也不代表它们由同一个位置生成。
不需要限制抓取的网站,可以保留简单规则。规则越长,越需要解释每一行为什么存在;看到后台路径、参数或英文目录,就一律封掉,很容易把文章样式、图片或者正常列表也带进去。
从一组能解释清楚的规则开始
下面是教学示例,假设这个网站确实存在/internal/目录,其中的guide子目录可以公开抓取:
User-agent: *
Disallow: /internal/
Allow: /internal/guide/
Sitemap: https://example.com/sitemap.xml
对按通用规则工作的爬虫,User-agent: *是没有更具体匹配组时的后备组;Disallow限制指定路径;Allow给出例外。Sitemap后面填写真实可用的地图完整地址,示例中的文件名需要按自己网站替换,它不负责“允许抓取”。保存时使用UTF-8纯文本,不要用文档编辑器生成带排版的文件。创建robots.txt的官方说明
读规则时,不能简单认为最后一行覆盖前面所有行。Google会根据匹配路径的具体程度判断;冲突且同等具体时采用更宽松的规则。因此上面的例外可以放行/internal/guide/start/,同时保留对/internal/draft/的限制。Google的路径匹配说明
如果希望限制的实际目录不是internal,不要照抄这个路径。先从网站里找一条确实需要限制的网址,再找一条相邻但应该保留的网址,把两者放在一起看;规则应当能区分它们。
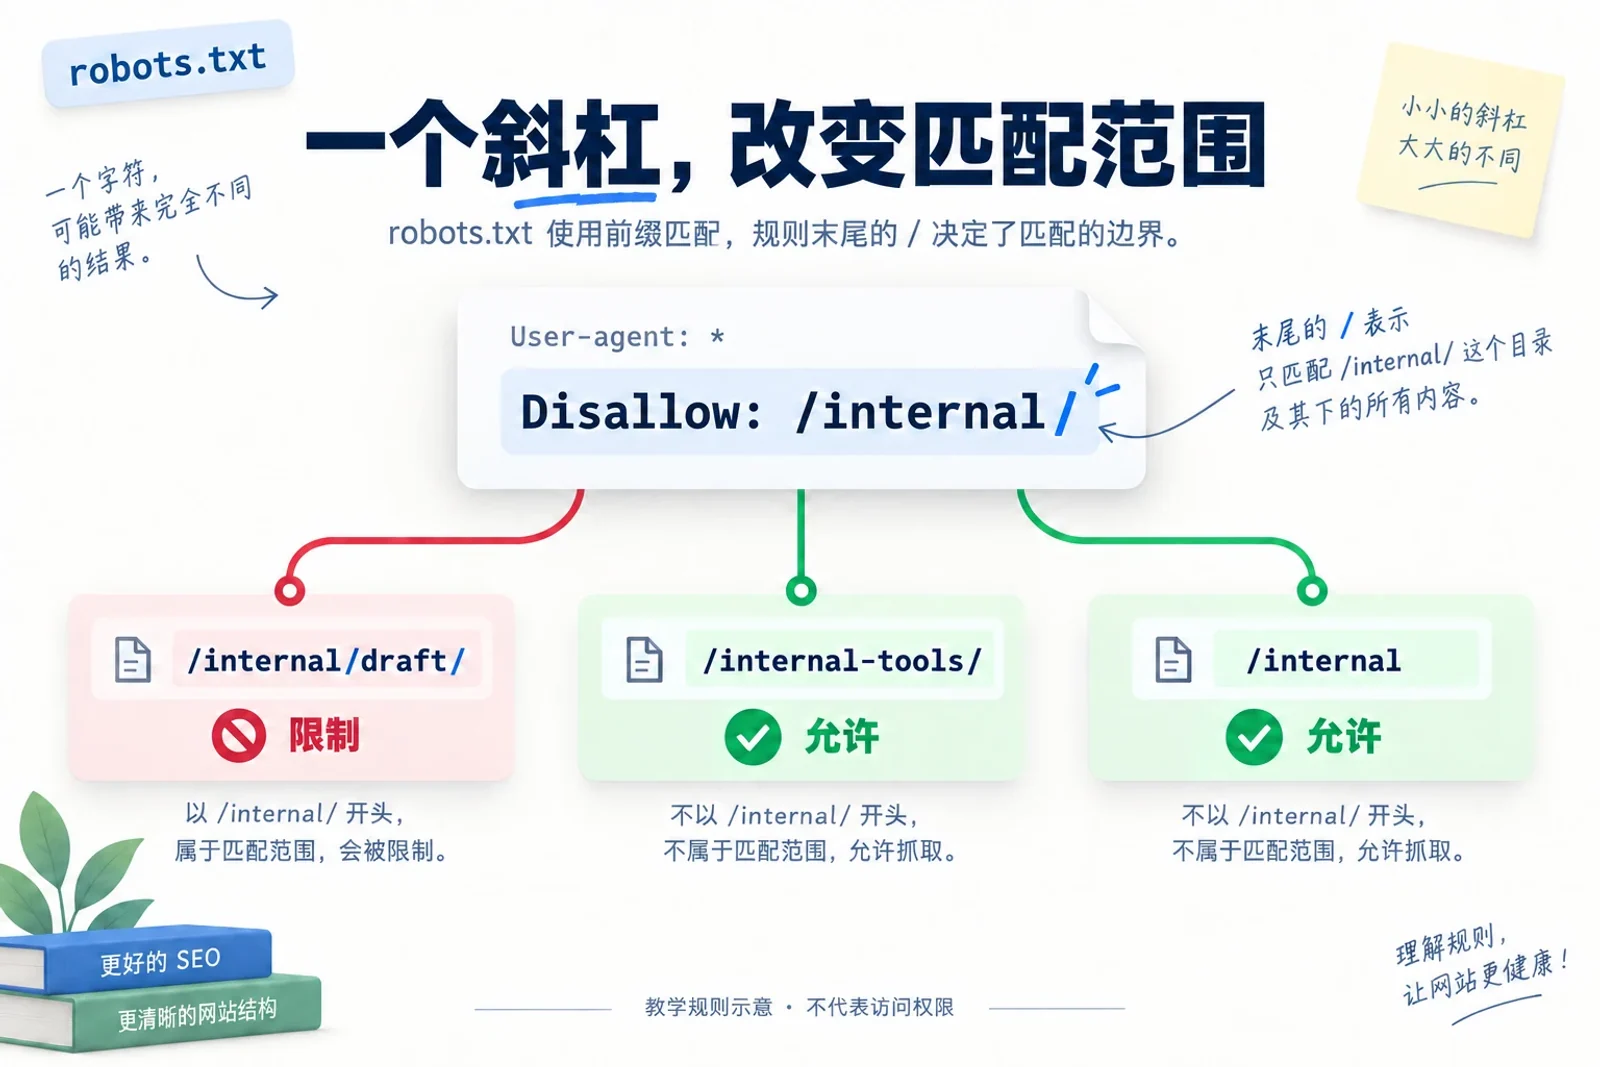
一个斜杠,会改变匹配范围
以下结果都只针对上一节的教学规则。它们不是网站实测数据,而是按规则对示例网址作出的判断:
| 网址路径 | 预期抓取许可 | 为什么 |
|---|---|---|
/internal/draft/ | 限制 | 落在被限制目录内 |
/internal/guide/start/ | 允许 | 命中更具体的允许路径 |
/internal-tools/ | 允许 | 并不以/internal/开头 |
/internal | 允许 | 缺少规则末尾的斜杠 |
/Internal/draft/ | 允许 | 路径大小写不同 |
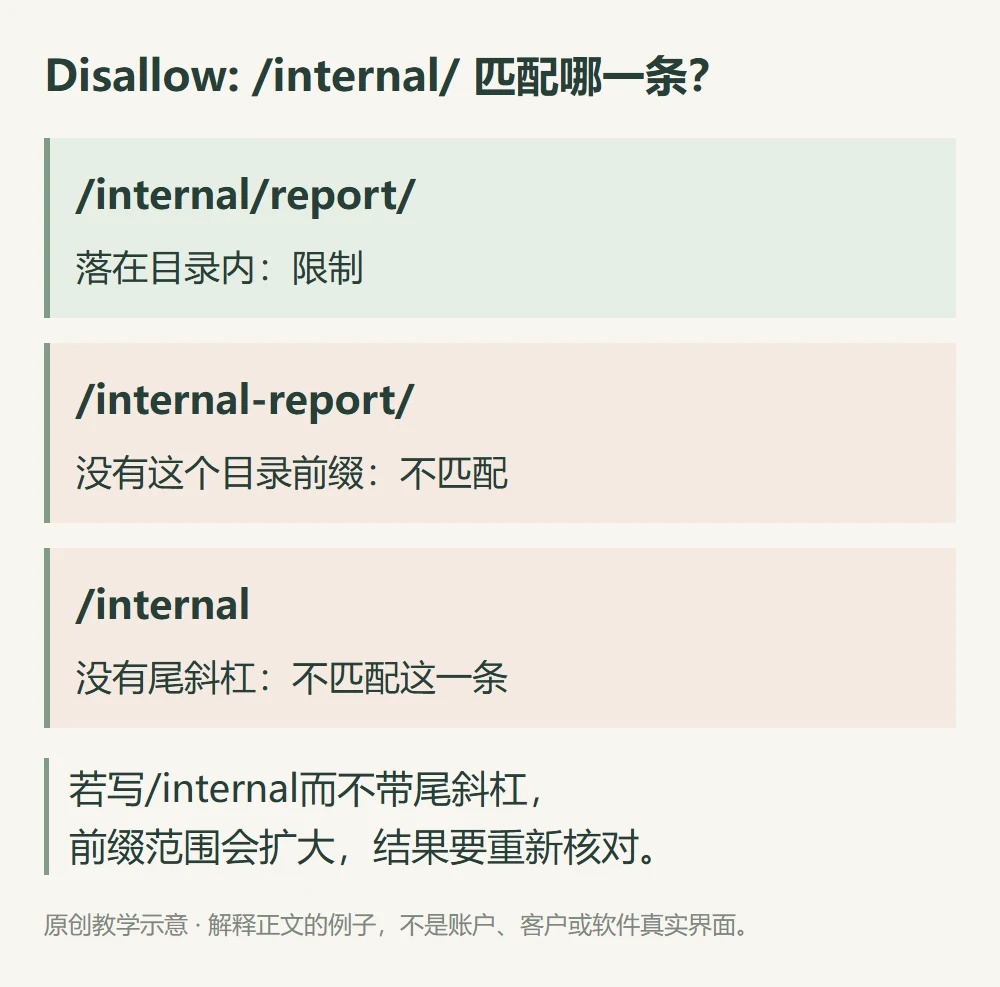
假如把限制改为Disallow: /internal,上表里的/internal-tools/和/internal也会被匹配。这是一个很适合上线前测试的反例:名称看起来相近的页面,未必属于同一个目录。路径前缀与大小写规则
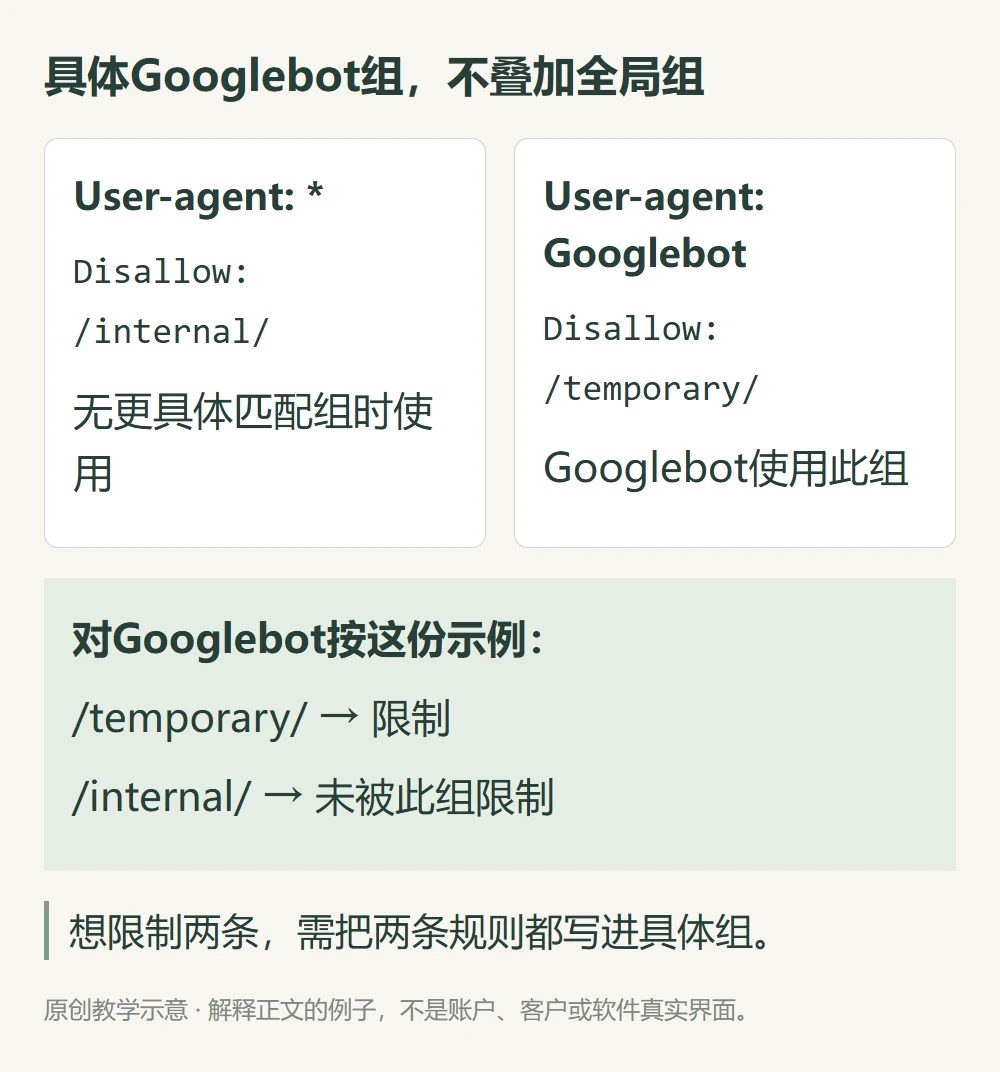
另外要检查爬虫分组。假设文件里既有User-agent: *,又有单独的User-agent: Googlebot,Googlebot会选择对它更具体的组,不会自动把通配组里的全部限制继承过来。若没有必须分别管理的原因,保持一组规则会更容易维护。需要多组时,就为每个组分别跑样本,不能只测试通配组。
通配符也应按需求添加:*代表可变字符,$表示结尾。不要为了“覆盖更全”随意在路径前后加星号。能够用明确目录解决的问题,先用明确目录,让下一位维护者也能看出限制边界。
把分组和参数写成能逐条核对的例子
Googlebot究竟读哪一组
先看一个容易误读的分组。以下仍是教学规则,不建议直接覆盖现有文件:
User-agent: *
Disallow: /internal/

User-agent: Googlebot
Disallow: /temporary/
对Googlebot而言,这份文件的适用限制是/temporary/;它不会因通配组那一行就禁止/internal/。若两处都需要对Googlebot限制,就要在Googlebot适用组内清楚表达这两个路径。对按通配组执行的其他爬虫,情况则不同。若把同一个用户代理拆进多个匹配组,还要考虑合并这些组的规则,不能假设第二组将第一组清空。robots协议的分组与匹配规则
几个相似写法也有不同结果:空的Disallow:不增加限制;Disallow: /限制全部路径;Disallow: /draft$只匹配以该内容结束的路径;去掉结尾符后,后续还有字符的地址也可能命中。不要把“空值”和“一个斜杠”视为同一种默认设置。
参数出现位置也要覆盖
参数需要实际列举。假设你只想限制特定排序参数产生的抓取,而普通产品与分页仍需开放,下面是一组语法演示:
User-agent: *
Disallow: /*?sort=
Disallow: /*&sort=
| 示例路径 | 按上面规则的预期 | 原因 |
|---|---|---|
/products/?sort=price | 限制 | 参数出现在问号后 |
/products/?page=2&sort=price | 限制 | 参数出现在另一个参数后 |
/products/?page=2 | 允许 | 没有sort参数 |
/products/?resort=price | 允许 | 参数名称不同 |
以上只是路径规则推导,不是一次真实站点测试。这种限制还需要满足业务前提:排序页面不承担独立搜索任务,重要产品仍能经其他正常链接被发现。如果目标是让已收录排序页退出索引,仅写这些规则仍不能完成;若页面需要被读取canonical,同样要考虑阻止抓取的影响。
不要把noindex:写进robots.txt当作索引指令,也不要认为增加Crawl-delay就能限制Googlebot速度;Google不支持用这些行完成上述目的。需要排除索引的HTML页面,应在页面层输出正确标记并允许读取;服务器压力则先核对请求和资源消耗,再用实际支持的控制方式处理。
WordPress后台改了,为什么前台没变
WordPress能够动态输出robots.txt;它的默认实现包含后台路径限制,以及admin-ajax.php的允许例外,还允许插件过滤输出。浏览器能打开这个地址,不代表服务器磁盘上一定有同名文本文件。WordPress的do_robots实现
因此,修改前先确定当前输出来自哪里:主机根目录中的实体文件、SEO插件或代码过滤,还是服务器及CDN层的特殊响应。可以先检查主机文件管理器中对应网站根目录,再看启用插件的文件编辑或robots设置。不同主机及插件入口不同,不能在没查来源时同时改几处。
确认来源后,保存一份旧内容和修改时间,再更新负责输出的那一处。发布后直接打开公共地址核对全文。如果后台已经是新规则,公共地址还是旧规则,先查缓存与输出来源;这时继续加第二套规则只会增加不确定性。
不要因为看到wp-admin就顺手封掉整个wp-content。后者可能承载前台图片、脚本和样式。若当前问题是页面抓取后缺少内容或资源,应连同抓取与索引排查一起判断,不能只用一条宽泛路径限制处理。
对于WordPress安装在根目录、后台路径采用默认形式的教学站,常见的基础内容类似下面这样。子目录安装和经过插件过滤的站点,应核对实际输出,不能认定所有WordPress都完全一样。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://example.com/wp-sitemap.xml
其中地图地址只是示意,要换成实际能打开、内容正确的地图或地图索引;装了SEO插件时,入口可能不同。前两条路径规则表达的是后台限制与一个更具体的例外。这个例外可能被前台功能使用,不能为了让文件看起来更严密随手删除。
如果插件文件编辑器保存成功却没有改变公开内容,先比较主机实体文件与公开返回。部分环境优先由实体文件响应,WordPress动态输出没有参与这次请求;CDN也可能返回先前缓存。主机处理方式并不完全一致,应依据当前请求找到实际负责的一层。WP Engine关于WordPress robots输出的说明
WordPress后台“建议搜索引擎不索引本站”的设置,也不能只通过robots.txt是否出现Disallow: /来验收。WordPress从5.3起相关默认实现转向robots元标记;插件和代码还可能调整行为。因此从测试站转正式站时,除检查文件,还要打开普通文章源码核对meta robots及响应头中的索引控制。WordPress默认实现及变更记录
上线验收,要看文件和具体网址
先在未登录状态打开robots.txt,确认拿到的是纯文本而不是登录页、验证页面或服务器报错。随后保存一组最小测试样本:一篇正常文章、一个重要产品或服务页、一项前台资源、一条应该限制的路径,以及一条允许例外。对每条样本记录“应允许还是应限制”,再对照实际规则。
在Search Console的“设置”中,可以通过robots.txt报告查看Google最近读取的文件、抓取时间和解析情况;有严重误封修复时,可在相应文件菜单请求重新抓取。该报告只对合适的域级资源提供,带子路径的网址前缀资源可能看不到。具体页面是否受限,仍应做该页面的URL检查。robots.txt报告说明
如果发现生产站误用了Disallow: /,先恢复已知正确的规则,并核对公共地址确实返回新版本,再请求Google重新读取。已经保存的正常页面样本,此时可以直接拿来复查;不要只看新文件里已经没有那一行就结束。
浏览器看到新规则,与Google已经读取新规则,是两次不同的验收。 规则更新后,正文重抓和搜索结果变化还需要后续处理。保留修改时间,并在Search Console索引报告中看受影响页面,能避免把旧状态误认为修复失败。
把“试几条URL”实际填出来,会更容易发现测试漏项。下面假设在一个教学站发现误加Disallow: /wp-content/,准备恢复到已经确认的基础规则;表中不代表本站的实际故障。
| 样本 | 希望的结果 | 当前问题与修复后的核对 |
|---|---|---|
/guide/普通文章 | 允许 | 文章本身原本开放,不能只测它就宣布正常 |
/services/服务页 | 允许 | 核对所用爬虫组,不只测试默认组 |
/wp-content/uploads/example.webp | 允许 | 旧宽泛规则误封图片,删掉该误封后重新判断 |
/wp-admin/edit.php | 限制 | 基础后台规则仍按预期适用 |
/wp-admin/admin-ajax.php | 允许 | 保留更具体允许例外,必要时实测前台功能 |
使用测试工具时,把你实际准备发布的全文和对应用户代理一起输入,再逐条记录结果;如果工具与手工判断不一致,先找所选规则组、命中路径和大小写。robots测试通过只说明这层许可,页面仍可能被登录、WAF、noindex或服务器故障影响。
文件响应异常时,先修访问层
文件规则没有变化,抓取也可能因响应改变而受影响。浏览器看到验证页面、CDN挑战或5xx时,继续编辑Allow通常解决不了问题,应交给负责主机或安全配置的人核对同一请求。
| 当前观察 | 排查重点 | 不应混淆的结论 |
|---|---|---|
| robots.txt返回正常文本,但目标URL仍受限 | 适用组、路径规则、Google所读版本和目标的其他限制 | 文件能打开不代表每条URL都放行 |
| 文件返回404 | 判断是否本来就没有需要管理的规则 | 对Google通常不构成全站抓取禁令 |
| 文件返回401或403 | 检查是否登录/防火墙误挡文件 | 不能用拒绝下载文件代替Disallow规则 |
| 文件返回429 | 检查服务器或CDN限速是否作用于robots.txt请求 | 429不属于Google按“无抓取限制”处理的普通4xx;不能照搬404分支 |
| 文件持续5xx、超时或DNS失败 | 先恢复稳定读取,记录故障时段 | Google可能暂停或依据缓存处理,不能当成正常无规则状态 |
以上状态需按Google的HTTP状态处理规则判断。
修复后分别留下“公共文件已恢复”“Google最近读取的内容已更新”“受影响页面重新获取”的时间。三者不一定同时发生;查看文件报告和具体URL,才能判断是在等待缓存更新,还是页面本身还存在另一项阻碍。
常见问题
robots.txt可以删除已经收录的页面吗?
不能依靠它完成这个目标。Google可能知道被限制网址,却无法读取页面上的noindex。如果希望一个仍公开的页面退出索引,应让Google能够获取它并读取正确的索引控制;敏感资料则先做真正的访问保护。Google的noindex说明
网站没有robots.txt,会不会影响收录?
缺少文件不等于禁止抓取。对Google而言,robots.txt正常返回404通常表示没有这份抓取限制;它与服务器持续返回5xx的情况不同。是否需要建立文件,取决于有没有明确路径要管理,不必为了“SEO必须有文件”添加无用限制。
限制了某个目录,为什么访问日志里还有请求?
先看请求时间、爬虫身份和它实际适用的规则组,再看Google最近读取的文件版本。旧缓存、分组不匹配或不遵守规则的程序,都需要分别判断。robots.txt不是防火墙;如果目标是阻止未授权访问,应在服务器或应用权限层处理。