把面包屑的名称和正式地址放进一份有序的路径数据,再用这份数据同时生成可点击导航和BreadcrumbList,就能减少“前台改了,标记没改”的问题。本文给出可运行的Node.js示例:输入三层路径,输出HTML和JSON-LD,并检查不该接受的地址。
这样的分工很常见:编辑把栏目改成“安装手册”,开发只改了屏幕上的导航;SEO插件或另一段代码仍写“资料下载”。两处看起来都能运行,读者与搜索引擎却拿到了不同路线。以后每改一次栏目,都要重新找两处来源,漏改还可能影响整批模板页。
下面的代码面向维护自定义模板、能运行Node.js的开发者。WordPress读者可先看后面的“WordPress已有插件”小节,确认现有生成来源;如果主题或SEO插件已稳定输出,优先修原来的来源;已有路径归类错误,可直接看面包屑分类与生成来源排查,不用为了这篇教程再加第二套代码。
先决定这页属于哪里,再写代码
面包屑回答的是“我在网站的什么位置,能返回哪里”。它通常放在正文前,像“资料中心 › 安装手册 › 过滤器更换指南”。前两项可点击,最后一项说明当前页。它不能代替主导航,也不必复述用户刚才点过哪些页面。
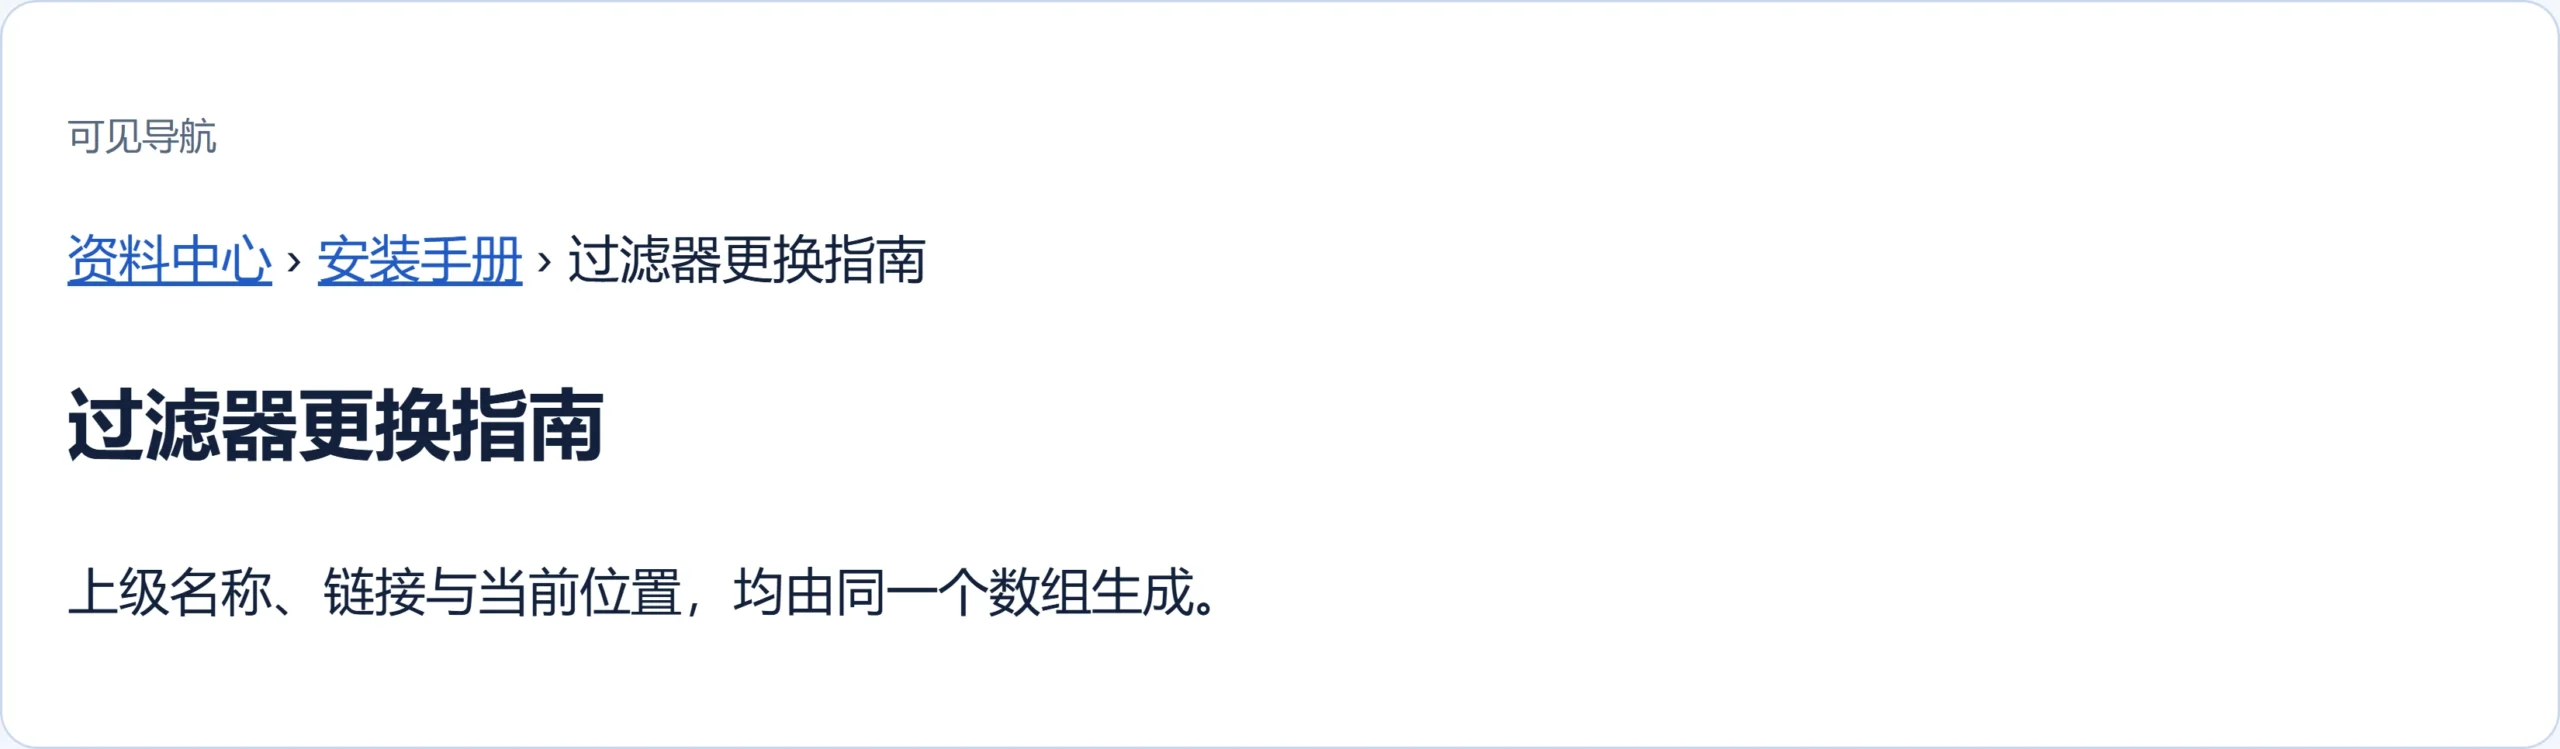
例如访客从促销邮件直接进入更换指南,他没有经过资料中心,页面仍可以显示这条稳定层级。若每次按浏览历史生成,“促销活动”“站内搜索”就可能混进上级,既不好解释内容归属,也让分享同一地址的读者看到不同路线。
另一个容易混淆的地方是网址。指南可以只有/filter-change/这个短地址,导航仍经过“资料中心”和“安装手册”。Google的面包屑说明建议表达典型用户路径,不要求逐段照抄URL。先打开拟定的父页,确认它真的能帮助找到这份指南,再把它放进数组。
同源数据能防止两处各改各的,却不会替你选对上级。若上级本身是空白页,程序只会一致地输出一条无用路线。整站的分类与文章关系,应先按SEO网站架构确定,再接这段代码。
输入只保留名称和正式地址
下面是虚构资料站的一条路线,example.com是教学域名。前两项是可返回的上级,最后一项是当前指南;顺序由外到内。
[
  {"name":"资料中心","url":"https://example.com/resources/"},
  {"name":"安装手册","url":"https://example.com/manuals/"},
  {"name":"过滤器更换指南","url":"https://example.com/filter-change/"}
]
实际使用时,换成已存在的名称和完整正式地址。不要为了让路径看着“SEO一点”,把未建好的关键词栏目写进去;也不要把用户随手填的任意地址直接带入模板。本例只接受指定站点下的HTTPS地址,这是演示模块的输入限制,并非Google要求所有面包屑必须满足的统一域名规则。
名称只存纯文字,链接只存地址。position不用编辑另填,由程序按数组顺序生成。这样新增一层时,维护者只改路径内容,不必同时维护第三份编号。
一个函数,同时生成导航与JSON-LD
在已安装Node.js的电脑或项目里,新建breadcrumb.cjs,保存以下完整内容,然后运行node breadcrumb.cjs。它没有额外软件包依赖,也不会访问示例网站;终端输出的是可以交给服务器模板使用的HTML字符串。
function renderBreadcrumb(trail, origin) {
const base = new URL(origin);
if (base.protocol !== 'https:') throw new Error('站点必须使用HTTPS');
if (!Array.isArray(trail) || trail.length < 2) {
throw new Error('路径至少需要两项');
}
const rows = trail.map((row) => {
if (typeof row.name !== 'string' || !row.name.trim()) {
throw new Error('每一项都需要名称');
}
if (typeof row.url !== 'string') throw new Error('地址必须是字符串');
const url = new URL(row.url);
if (url.protocol !== 'https:' || url.origin !== base.origin ||
url.username || url.password || url.search || url.hash) {
throw new Error('请使用本站不带参数、片段或登录信息的HTTPS地址');
}
return { name: row.name.trim(), url: url.href };
});
if (new Set(rows.map((row) => row.url)).size !== rows.length) {
throw new Error('路径里出现重复地址');
}
const escapeHtml = (text) => text.replace(/[&<>"']/g, (ch) => ({
'&': '&', '<': '<', '>': '>',
'"': '"', "'": '''
})[ch]);
const items = rows.map((row, i) => {
const label = escapeHtml(row.name);
const separator = i ? '<span aria-hidden="true"> › </span>' : '';
const content = i === rows.length - 1
? `<span aria-current="page">${label}</span>`
: `<a href="${escapeHtml(row.url)}">${label}</a>`;
return `<li>${separator}${content}</li>`;
}).join('');
const nav = `<nav class="breadcrumbs" aria-label="面包屑导航"><ol>${items}</ol></nav>`;
const data = {
'@context': 'https://schema.org', '@type': 'BreadcrumbList',
itemListElement: rows.map((row, i) => ({
'@type': 'ListItem', position: i + 1,
name: row.name, item: row.url
}))
};
const safeJson = JSON.stringify(data).replace(/</g, '\\u003c');
const jsonld = `<script type="application/ld+json">${safeJson}</script>`;
return { nav, jsonld };
}
module.exports = { renderBreadcrumb };
if (require.main === module) {
const trail = [
{ name: '资料中心', url: 'https://example.com/resources/' },
{ name: '安装手册', url: 'https://example.com/manuals/' },
{ name: '过滤器更换指南', url: 'https://example.com/filter-change/' }
];
const result = renderBreadcrumb(trail, 'https://example.com');
console.log(result.nav + '\n' + result.jsonld);
}
这里有三处比“拼几段文字”多做了一步。第一,所有地址先经过URL解析,再核协议和站点,避免把javascript:或别站链接误当本站上级;它还主动拒绝参数和片段,本例用的是干净正式地址。若项目确实用参数代表独立页面,需要按实际URL方案修改校验,不能直接删掉所有限制。
第二,名称被当作文字处理。即使名称里出现<或引号,也应显示为文字,不该变成新标签。程序分别处理HTML转义和JSON序列化;JSON里的<另转成转义序列,是为了避免名称中的</script>提前结束脚本标签。两份输出共享的是内容,输出格式仍需要各自处理。MDN的文字与HTML区别能帮助理解为什么不能把名称当作现成HTML直接插入。
第三,当前页显示文字,上级才提供返回链接。导航有名称,装饰分隔符对辅助技术隐藏,当前位置有标识;这些细节来自W3C面包屑模式。使用站点本来的字体与颜色即可,不必把导航做成醒目的第二个标题。
若主题没有面包屑样式,可在主题样式表中加入以下最小规则,让列表横排并能在窄屏自然换行。它只处理这个示例类名,不改整站所有列表。
.breadcrumbs ol { display:flex; flex-wrap:wrap; gap:.25em; list-style:none; padding:0; }
.breadcrumbs li { margin:0; overflow-wrap:anywhere; }
.breadcrumbs [aria-current="page"] { color:inherit; }
跑完以后,读者和搜索引擎各得到什么
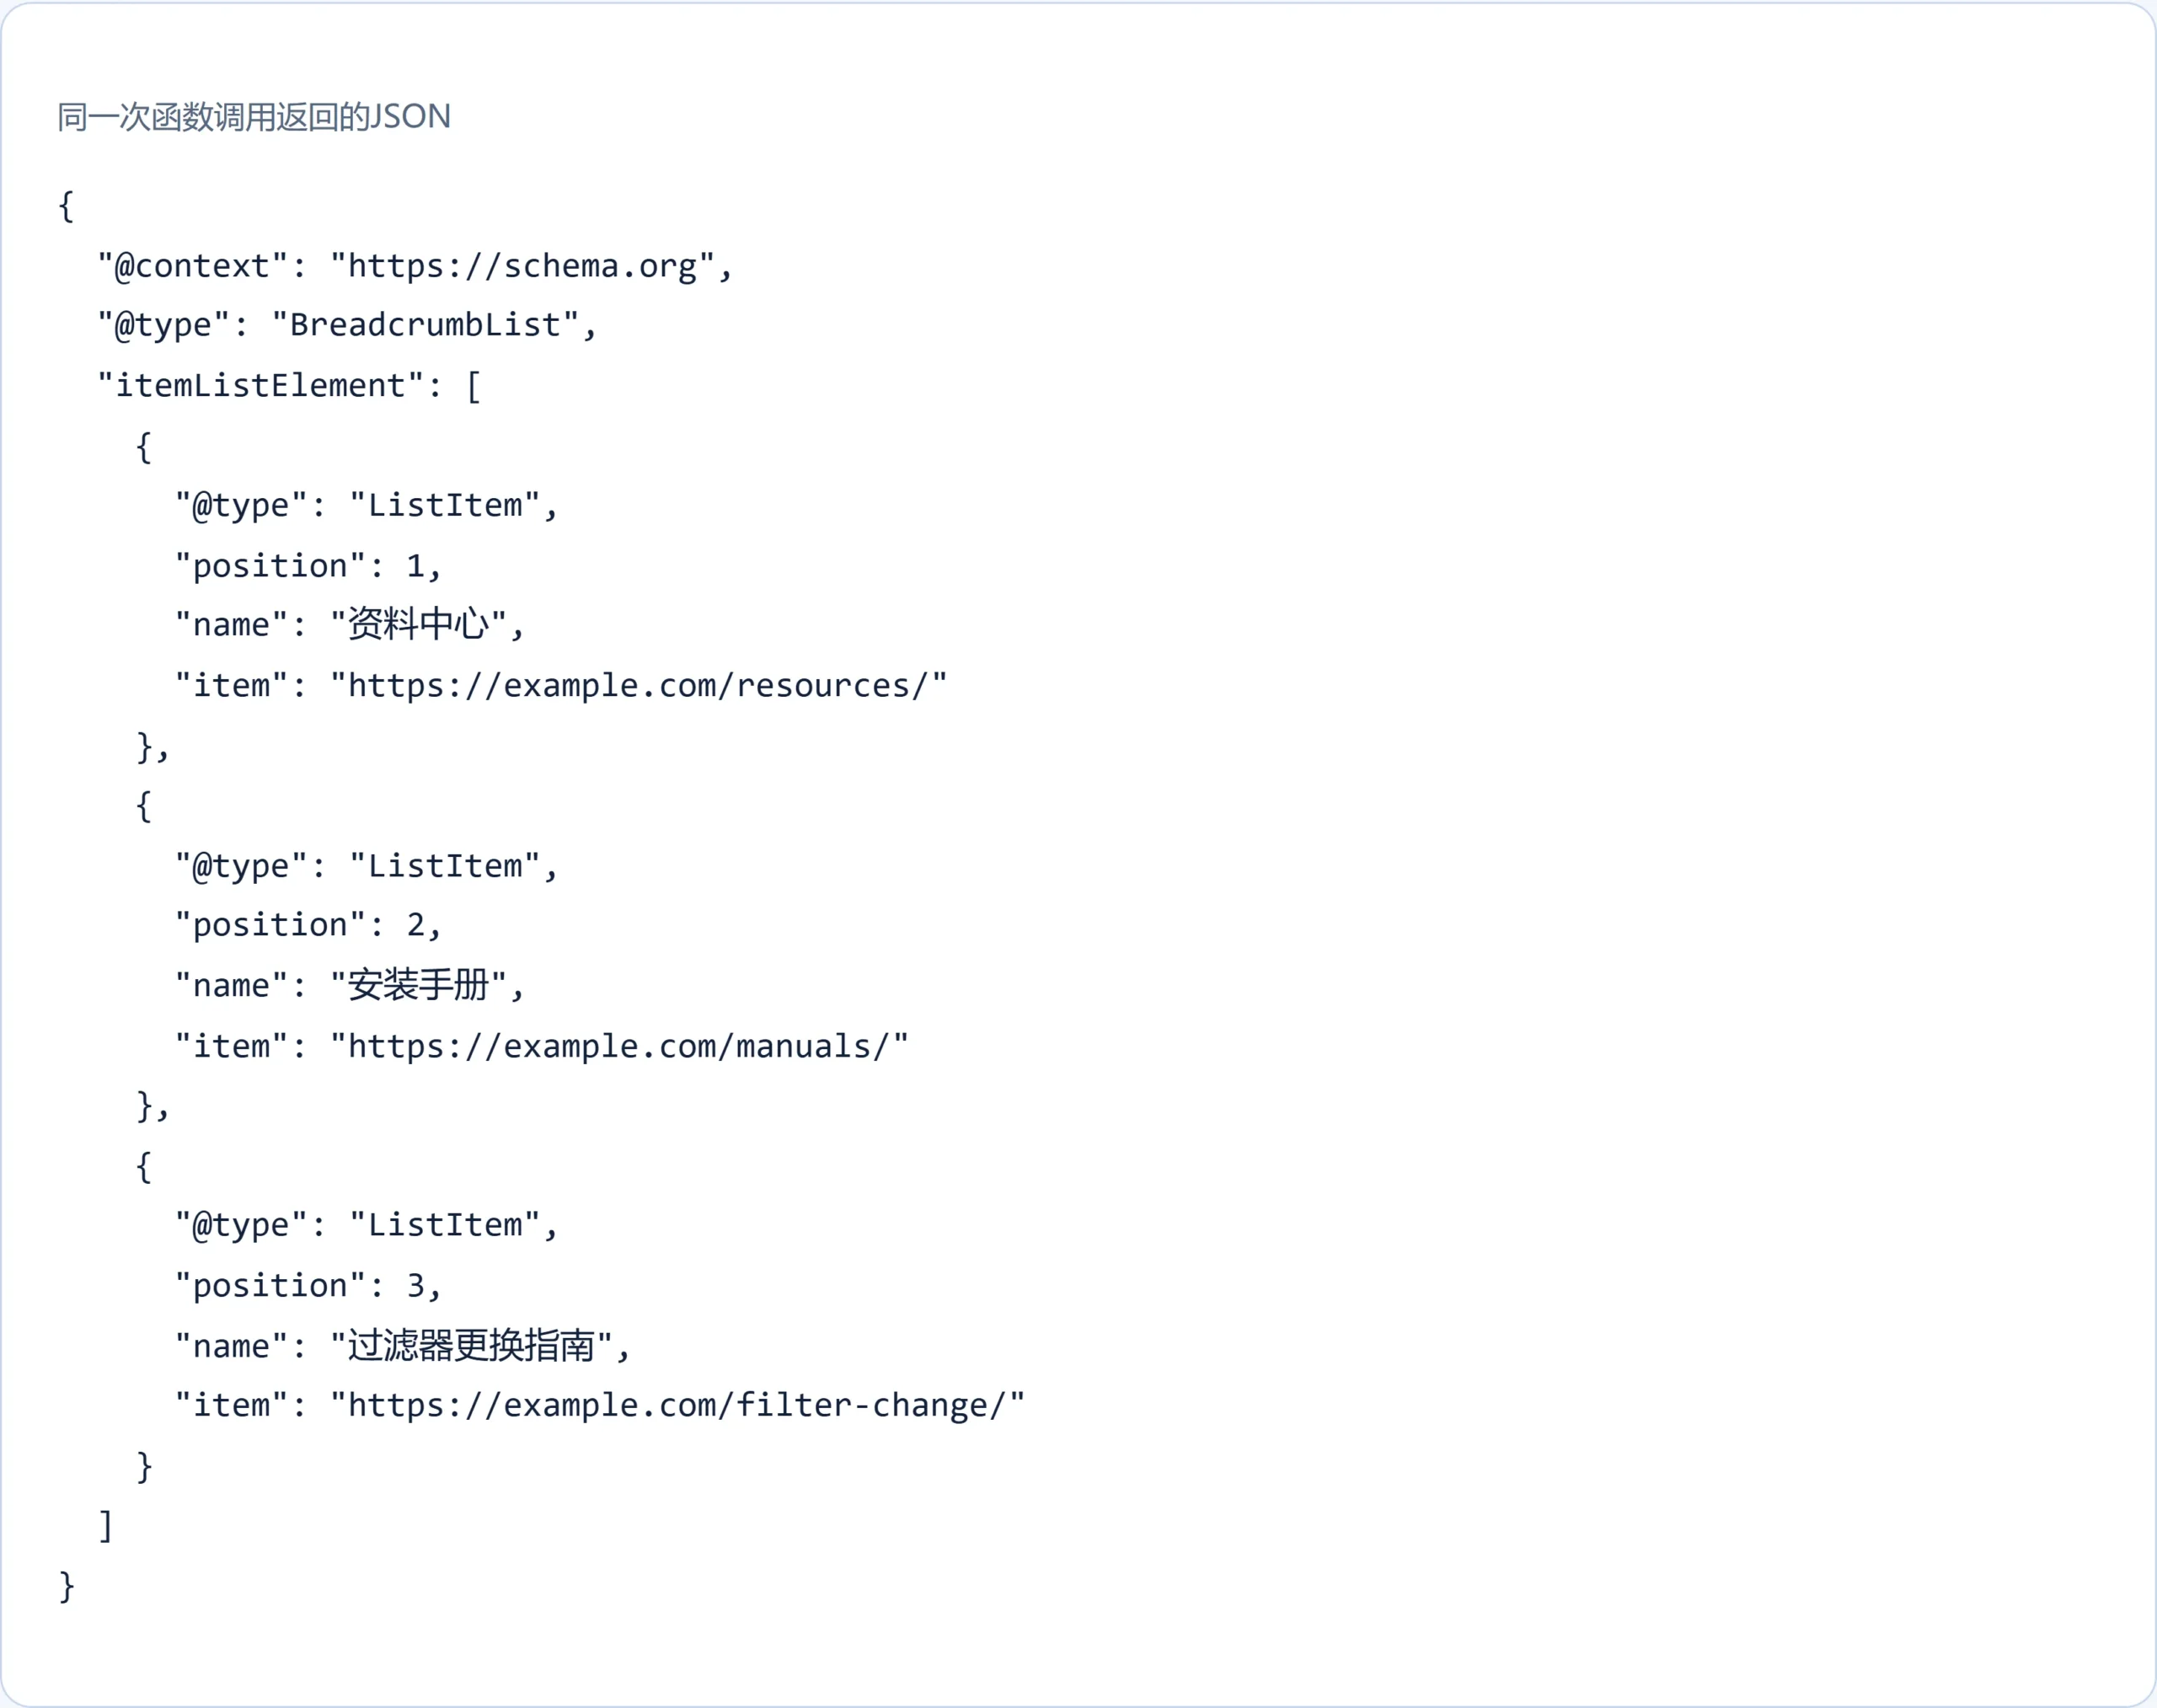
正常输入会生成“资料中心 › 安装手册 › 过滤器更换指南”。前两项链接分别去数组里的地址,最后一项是当前页文字。JSON-LD则把相同的名称和地址放进itemListElement,位置依次为1、2、3。示例保留了当前页的地址;规范允许最后一项省略item,并不要求你删除它。
把第二项名称改成「维护手册」再运行,页面导航和 JSON-LD 都会显示这个新名称。检查这两处,就能确认改名有没有漏掉一边。名称变了,内容也应该符合“维护手册”;若父页实际仍是别的资料,代码不会替你判断。
本次对文中程序做了本地受控检查,结果如下。它证明给定输入下的输出与失败处理,不代表Google已测试、索引或展示了这个示例。
| 输入或检查动作 | 实际结果 | 能说明什么 |
|---|---|---|
| 第二项由安装手册改成维护手册 | 导航与JSON名称同步变化 | 两者使用同一份名称 |
| 读取三个position及末项HTML | 顺序为1、2、3;末项没有链接 | 位置与当前位置处理符合本例设计 |
| 名称包含标签和结束脚本字符 | 导航显示转义文字;JSON解析仍还原原文字 | 名称不会被直接当作HTML标签拼入 |
| 换成javascript地址、其他站地址或带参数地址 | 程序报错,不返回正式输出 | 本例的地址限制确实执行 |
| 只留一项、名称为空或重复地址 | 程序报错 | 缺失路径信息不会悄悄通过 |
报错时先修输入。把程序改成“遇到错误就输出空标记”,只会把错误藏起来,页面仍然没有可用的面包屑。若真实项目允许某类被拒绝的地址,应明确它为何必要,再修改并补上对应检查,别为了消除报错绕过整个校验。
接入模板时,只保留一个负责生成的地方
自定义服务器模板:每页提供自己的路径
在Node项目中用require('./breadcrumb.cjs')取得函数,把当前页经过审核的路径传进去。将返回的nav放在正文前;jsonld由模板输出一次。路径应来自同一份内容配置或已确定的分类关系,不要让编辑另外填一段静态JSON。
函数返回的是HTML字符串。不同模板引擎对字符串有自己的转义规则:若页面显示出<nav>这些字,说明模板把整段输出再次当作普通文字;由维护者在确认数据经过本例校验和转义后,用该引擎的受控HTML输出方式接入。不要把任意用户提交的HTML照此放行。仅运行命令看到字符串,也还没有完成网站接入。
服务器生成或静态构建时输出,便于在实际HTML中核对。如果是前端应用,路由切换后也要取得新路径并替换旧输出,不能只在第一次打开页面时生成。本例没有实现你的路由系统,接入者仍需完成这部分生命周期处理。
WordPress已有插件:修来源,别叠加演示代码
WordPress不会直接执行这份Node文件。如果主题和插件已经提供面包屑,就使用它们现有的分类和模板接口。例如Yoast实施说明分别讨论启用、主题接入、区块与短代码;一个设置开关并不等于页面上所有来源都已经接通。
请维护者确认:谁提供路径数据,谁画可见导航,谁生成JSON-LD。如果是两个组件,就让它们读取同一个已确认的分类来源,或由现有生成器统一负责。教程中的代码用于理解和实现这种关系,不能粘进文章正文后期待WordPress自动接管整站。
一个页面确实可以有两条合理路线,例如同一资料分别从“安装手册”和“设备维护”进入。需要两条时,应分别维护真实路径并生成对应列表;本例只生成一条,不根据访客上一页临时猜路线。多个真实路径与两份互相矛盾的旧代码也要分开判断。
最后检查实际网页,而不只看代码没有报错
先以未登录访客打开正式页,点每一个上级链接。确认目标页确实帮助找到当前内容,窄屏仍能读清名称和分隔关系。再查看网页实际输出的BreadcrumbList,逐项对照名称、地址和顺序;搜出额外列表时,查它的来源和用途,别把第二份错数据留在旧插件里。
随后用富媒体搜索结果测试检查正式 URL,核对发现的路径与字段错误。代码测试适合先检查片段,但不能证明服务器、缓存或权限给Google提供了同样内容。首次接触标记,可先看JSON-LD添加与验证,再回到真实网页验证。
共享模板修改后,至少核不同层级、不同分类和没有可用上级的页面,避免这条演示路线被写死在每一页。把问题放进技术SEO审计时,应写清具体模板、错误输出和正确路径,方便维护者定位,而不是交一句“优化面包屑”。 分类、导航和正文关系还没理清时,可从网站架构专题先确认页面分工。
Google的搜索面包屑展示目前适用于桌面;2025年的手机搜索调整已移除手机结果中的这段路径。手机搜索没显示,不等于网页导航失效。先验收网页,再看Google后续抓取和选择展示;写对代码不保证一定出现富结果或提高排名。
上级路径已经对齐后,还要检查正文的相关推荐:面包屑只能返回层级,不能替读者选下一篇教程。整站任务可按谷歌SEO完整流程安排;需要理解导航、分类与内容的分工,可从谷歌SEO学习路径选相应基础。
常见问题
一定要把首页放进面包屑吗?
不必为凑完整而强加首页。Google不强制包含站点顶层或当前页这一项;列表本身至少两项。本例从资料中心开始,是为了展示读者真实使用的两级返回入口。
JSON-LD已经有了,还需要可点击导航吗?
JSON-LD不会自动在页面上画导航。若目标包括帮助访客返回上级,就应提供真实可用的可见链接;本例分别生成两者,不把机器可读数据当作用户界面。
可以把产品名称或文章标题自动放进最后一项吗?
可以从同一内容记录取名称,但仍应作为文字处理,按相应输出格式转义。标题可能含引号、符号甚至被错误录入的标签;不要因为数据来自后台就直接当作HTML拼接。