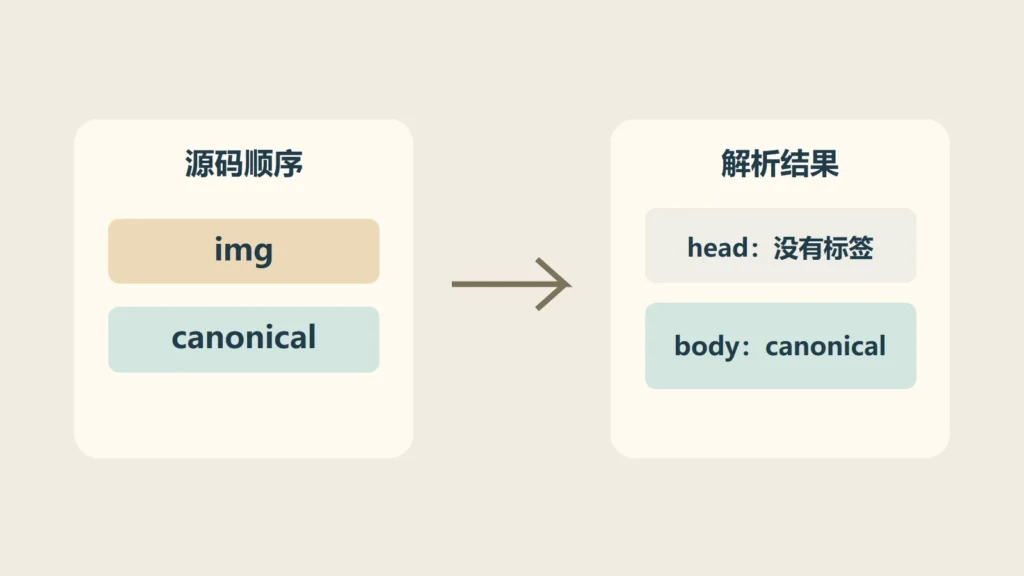
SPA(单页应用)站内切换页面,可能只替换正文,没有重新加载整份文档。出现“内容已经是B,标签页标题或canonical还是A”时,先对比直接打开B与从A点击进入B,再一起记录当前网址、H1、文档标题和规范地址,查负责标题和规范地址的组件有没有收到新页面的数据,以及迟到的旧请求有没有把值改回去。
这种问题容易漏检:开发直接刷新B,一切正常;运营沿菜单进入B,却看到上一页标题。双方各截一张图,看起来都没错,实际上走了不同的访问过程。只验收“刷新后正常”,就会把站内导航、前进后退和快速切换中的遗漏一起留下。
若连正文都没出现,先看JavaScript正文读取与渲染检查;本文处理的是页面切换过程中内容与元信息不同步。
运营可先按前两节准备A、B和两种进入方式;控制台采集与后面的更新链检查面向开发者。交接时提供同一次切换的记录,不必先猜框架或插件。
地址栏变了,不一定换了一份文档
普通整页跳转会请求新文档,服务器可以随新HTML提供标题和规范地址。单页应用的客户端路由,则可能保留原文档,取得新数据后换掉正文,再通过History API改变地址栏。
因此,界面上的大标题变了,只能证明那个正文节点更新了。浏览器标签页读的是文档title,canonical又是另一项页面声明;它们不会因为H1换字就必然跟着变化。框架可以负责同步,但前提是现有实现确实接入了正确的路由和数据。
MDN的History API说明解释了这种局部更新与历史记录的关系。pushState()第二个参数不是“替页面设置标题”的开关,兼容写法使用空字符串;实际文档标题应由对应实现更新。按浏览器后退,也需要恢复相应状态,不能只处理点击菜单这一条路。
这里的判断不是“SPA不适合SEO”。先找到当前实现漏了什么,再决定需要修哪一处;是否改成SSR或静态生成,是渲染方案选择里的另一项决定。
先把两种打开方式分开记录
选两个已经存在、内容明确不同的公开页面,记作A和B。先在新窗口直接打开B,记录完整地址与页面信息;再从A出发,使用网站本来的菜单或链接进入B,观察同样的字段。
第二次观察时先不要刷新。刷新可能重新请求B的正确HTML,把只在客户端切换时出现的遗漏抹掉。记录“起点A、点击哪个链接、目标B”,比一句“标题偶尔不对”更容易让维护者复现。
也要区分观察工具。切到B以后再点“查看源代码”,浏览器可能另外请求B的源码;它不能单独证明刚才A切到B的过程中,当前文档如何更新。要核当下状态,用Elements或下面的只读采集;要核B服务器输出,再直接请求B的主文档响应,两份证据分别保存。
如果直接B与A到B都错,先看B的模板或数据来源。如果只有站内切换出错,检查从 A 切到 B 时,负责标题和规范地址的代码有没有重新运行。再试一次后退与前进,能帮助识别遗漏是不是只发生在恢复历史状态时。 其他抓取、规范地址与渲染问题,可在技术SEO专题按现象选择排查路线。
同一时刻,读取网址、H1、title和全部canonical
熟悉开发者工具时,可以在目标公开页的Console运行下面这段只读代码。它只读取当前值,不修改页面,也不安装任何脚本。不熟悉控制台,就让维护者用Elements检查正文H1与head中的对应节点。
({
  url: location.href,
  h1: document.querySelector('h1')?.textContent.trim(),
  title: document.title,
  canonical: [...document.querySelectorAll('head link[rel="canonical"]')]
    .map(link => link.href)
})
document.title读的是此刻文档标题,见MDN的title属性说明。canonical取全部匹配项,是为了发现重复输出;只读第一个,可能正好漏掉另一套组件留下的旧值。
这段读取的是HTML标签。如果项目用HTTP的Link响应头声明规范地址,也要核主文档响应;数组为空,不能单凭这一点断定网站没有任何规范声明。
刚切换时读一次,页面数据稳定后再读一次。若标题先变B、随后又回A,和“从头到尾没变过”是不同线索。把两次观察时刻及当时请求记录交给开发,不必先猜是哪个SEO插件或框架有问题。
按四种迹象,检查对应的更新逻辑
只有第一次加载时设置了标题
直接打开每个URL都对,A点击到B后正文变化、元信息一直不变,先查标题和规范地址是不是只在应用初始化时写入。组件换了,原来负责head的逻辑却没收到新路由,或者把第一份数据一直保存在共享状态里。
修复重点是让负责元信息的现有来源跟随当前页面更新。不要在每一篇正文额外塞一段设置标题的脚本;这会多出一套职责,后续更难知道谁最后改了值。
先正确,过一会儿又被旧页面覆盖
假设A的数据请求先发出,却较慢;用户随即切到B,B先完成,旧A最后才回来。若每个完成的请求都能改正文或标题,地址栏虽然停在B,A仍可能把状态写回去。
让开发核对请求发起顺序、返回顺序和实际写入者。可按当前路由检查是否仍应提交这份结果,必要时取消不再需要的请求;AbortController的取消能力是可用工具之一,具体还要接好项目的错误处理。A 的结果到达时,如果用户已经在 B,就丢弃这份过期结果。
两个组件都在生成canonical
服务器或框架已有一份,后来又有自定义组件追加一份;页面可能同时留下A与B。也可能只剩一项,却被两个来源反复改写。先找出哪些组件在生成或修改canonical、各自何时触发,再确定由哪一处统一处理,不能靠把“正确的”再追加一次来盖掉旧值。
这里只说排查方向。看到两个值,要看实际来源和规范意图;不能不读代码就断定某个组件必须卸载。
网页当前值正确,只有统计报表落后一页
这时再查统计事件是不是在标题更新前就发送了。Matomo的React SPA说明就记录了这种触发时序:History变化事件可能早于组件更新title。它能解释一种机制,不能直接当成你使用的所有统计工具都采用相同配置。
先确认浏览器当前字段是否正确,再核事件发出时携带的值。只因报表里有旧标题,就去改已经正确的canonical,反而会制造另一个问题。
canonical还要核“同一个URL”的初始输出
路由切换时同步字段,只解决当前浏览器状态。对希望独立索引的B,仍要直接请求B,确认服务器输出和正常渲染给出的规范目标一致。不能让所有地址的原HTML先指A,再指望脚本一律改成当前地址。
Google的canonical实施建议优先让原HTML提供清楚的规范信息,并避免JavaScript把同一URL的规范目标改成另一个。确实只能由JavaScript生成时,应正确输出,避免初始错误声明与后续正确声明打架。JavaScript SEO说明也提醒不要产生冲突或多份canonical。
这里比较的是B的原HTML与B正常渲染后的结果。A最初加载的HTML,不能当成B服务器响应的证据;这也是为什么前面要把直接打开与软切分开记录。修好A到B的交互后,仍需单独检查B的直达入口。
B也不必一律声明自己。若B本来是重复版本,规范到已确认的主页面可能符合设计。先弄清内容关系,再验收那个正确目标,具体可看canonical设置与排错。canonical帮助表达首选版本,不负责让URL自动跳转,也不保证Google最终采用声明。
一个本地演示,怎样把三种情况分开
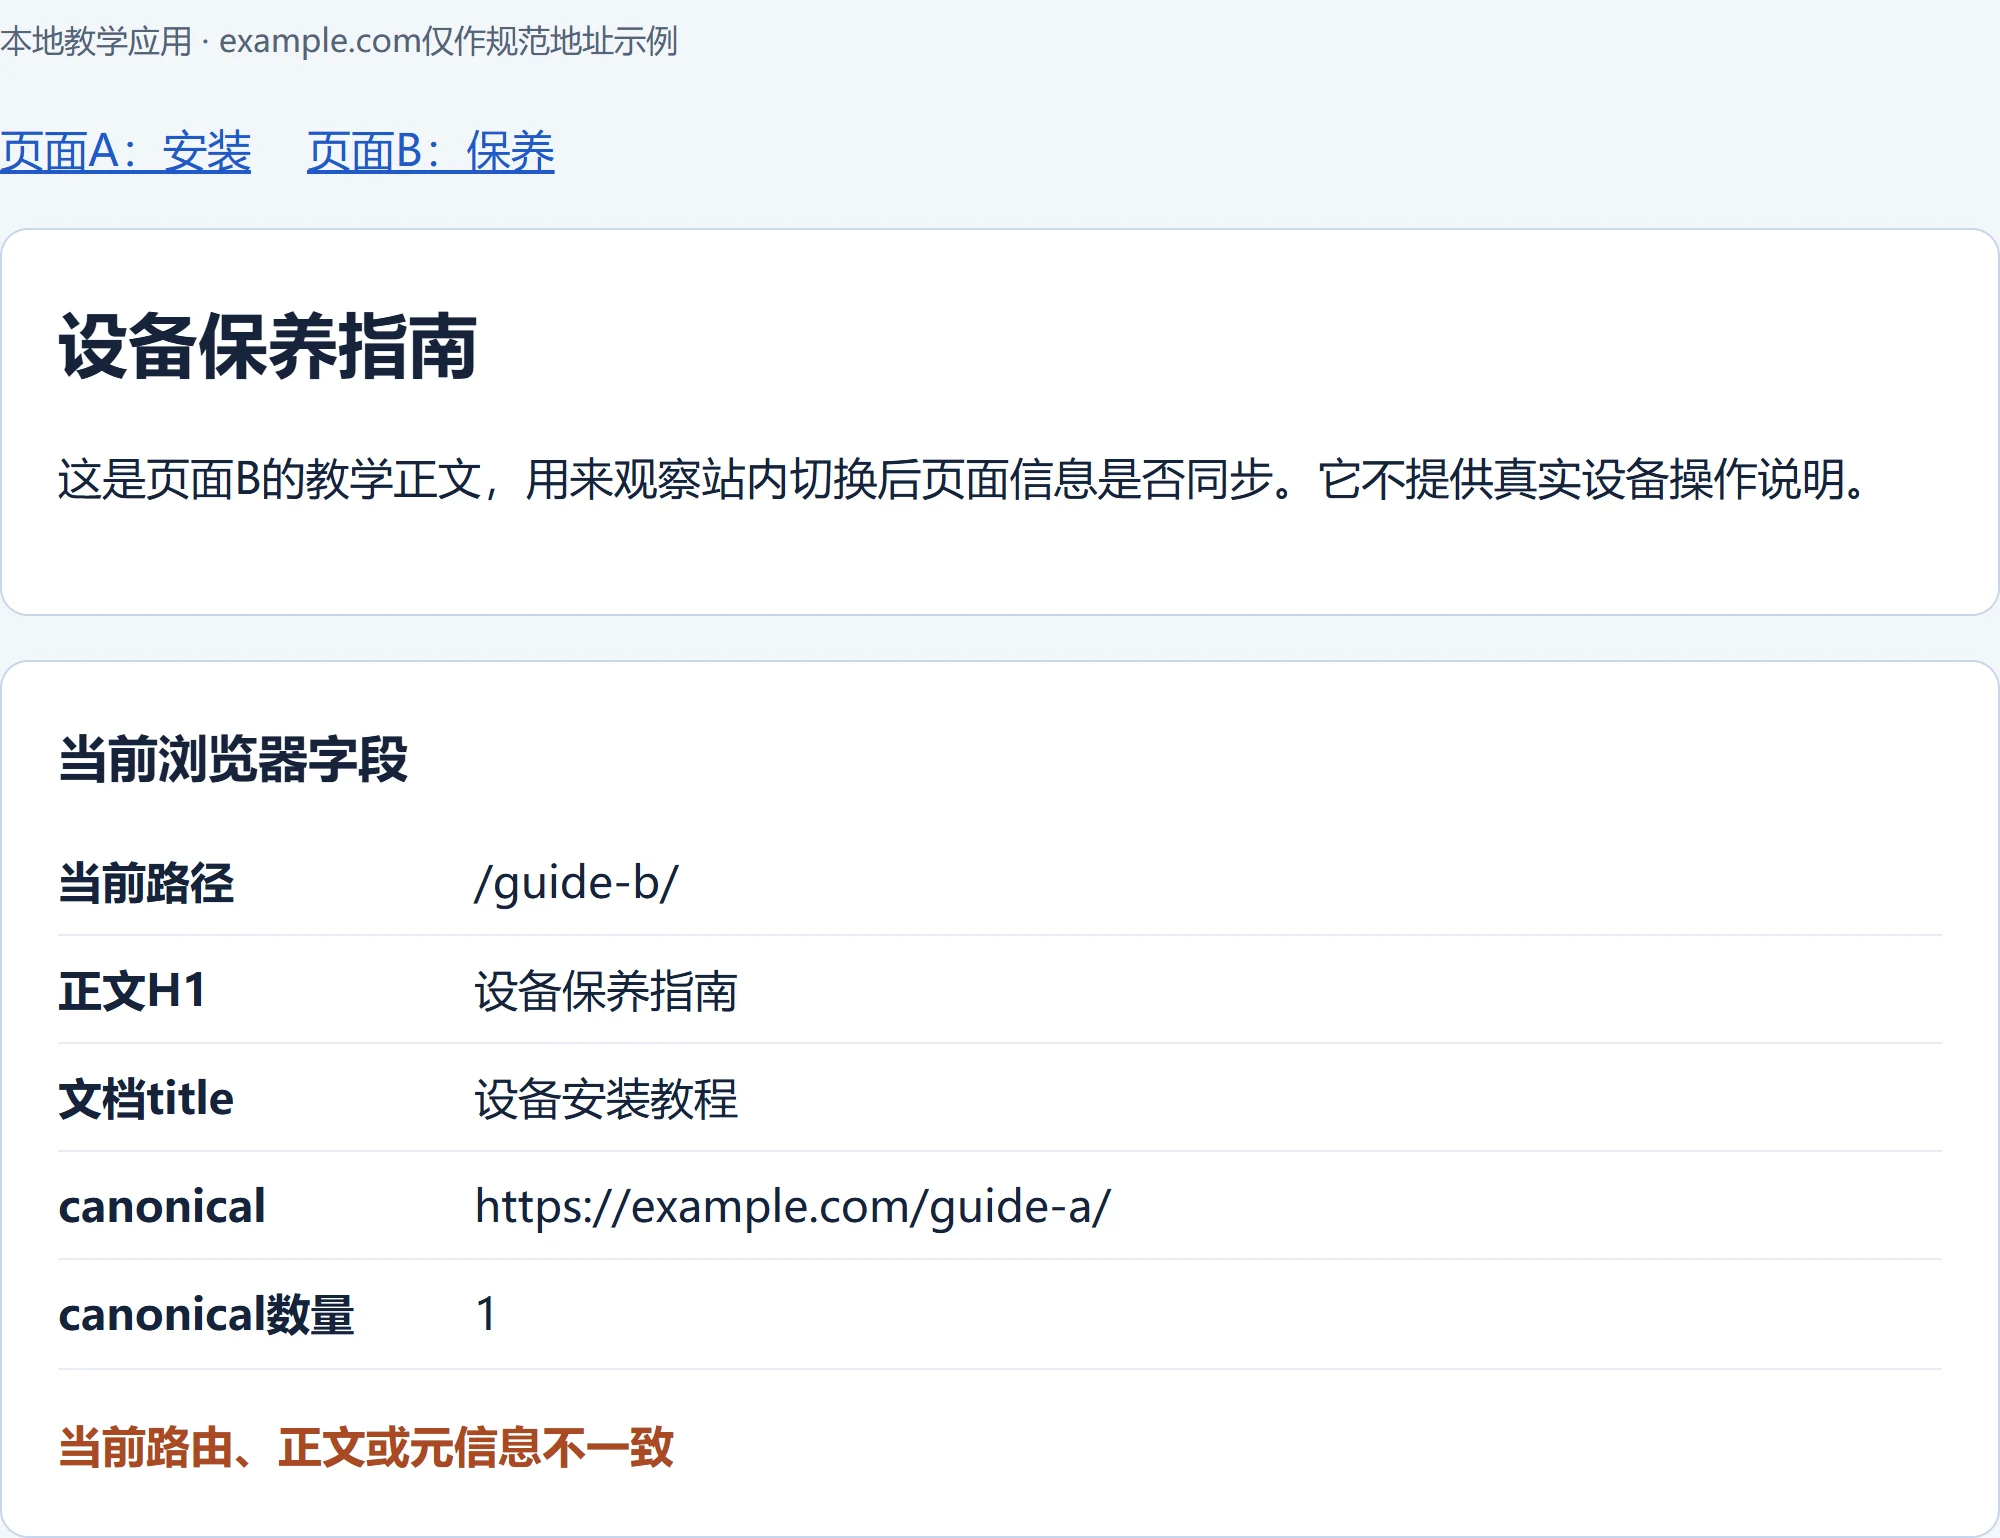
本次用两篇虚构教程做了受控HTTP和浏览器演示:A叫“设备安装教程”,B叫“设备保养指南”,分别使用/guide-a/与/guide-b/。两页都计划独立存在,各自声明对应的教学规范地址。页面在本机运行,example.com只用于示例字段,不是本站线上页面。
演示先让服务器直接打开B时提供B的内容与元信息,再分别运行“只换正文”“异步结果不检查当前路由”“按当前路由统一提交”三种逻辑。实际观察如下:
| 访问与实现 | 当前观察到的字段 | 这次能看出什么 |
|---|---|---|
| 直接打开B | 路径、H1、title和canonical均对应B | B的直达输出本身正常 |
| A点B,只更新正文 | 路径与H1是B;title和canonical仍是A | 站内切换没把元信息带进更新 |
| 先请求慢A,再请求快B,不拦旧结果 | 路径仍是B;H1、title和canonical最后变回A | 旧响应覆盖了当前页面 |
| 同样快切,按当前请求统一提交 | 四项均对应B,canonical只有一项 | 本例中旧响应不再覆盖当前页面 |
“只换正文”这次切换没有产生新的主文档请求,浏览器保留原文档,仅请求数据。修复版本把正文和元信息一起更新为当前页面的值,同时忽略过时的请求结果;另测后退回A、前进到B,字段也分别恢复到对应页面。
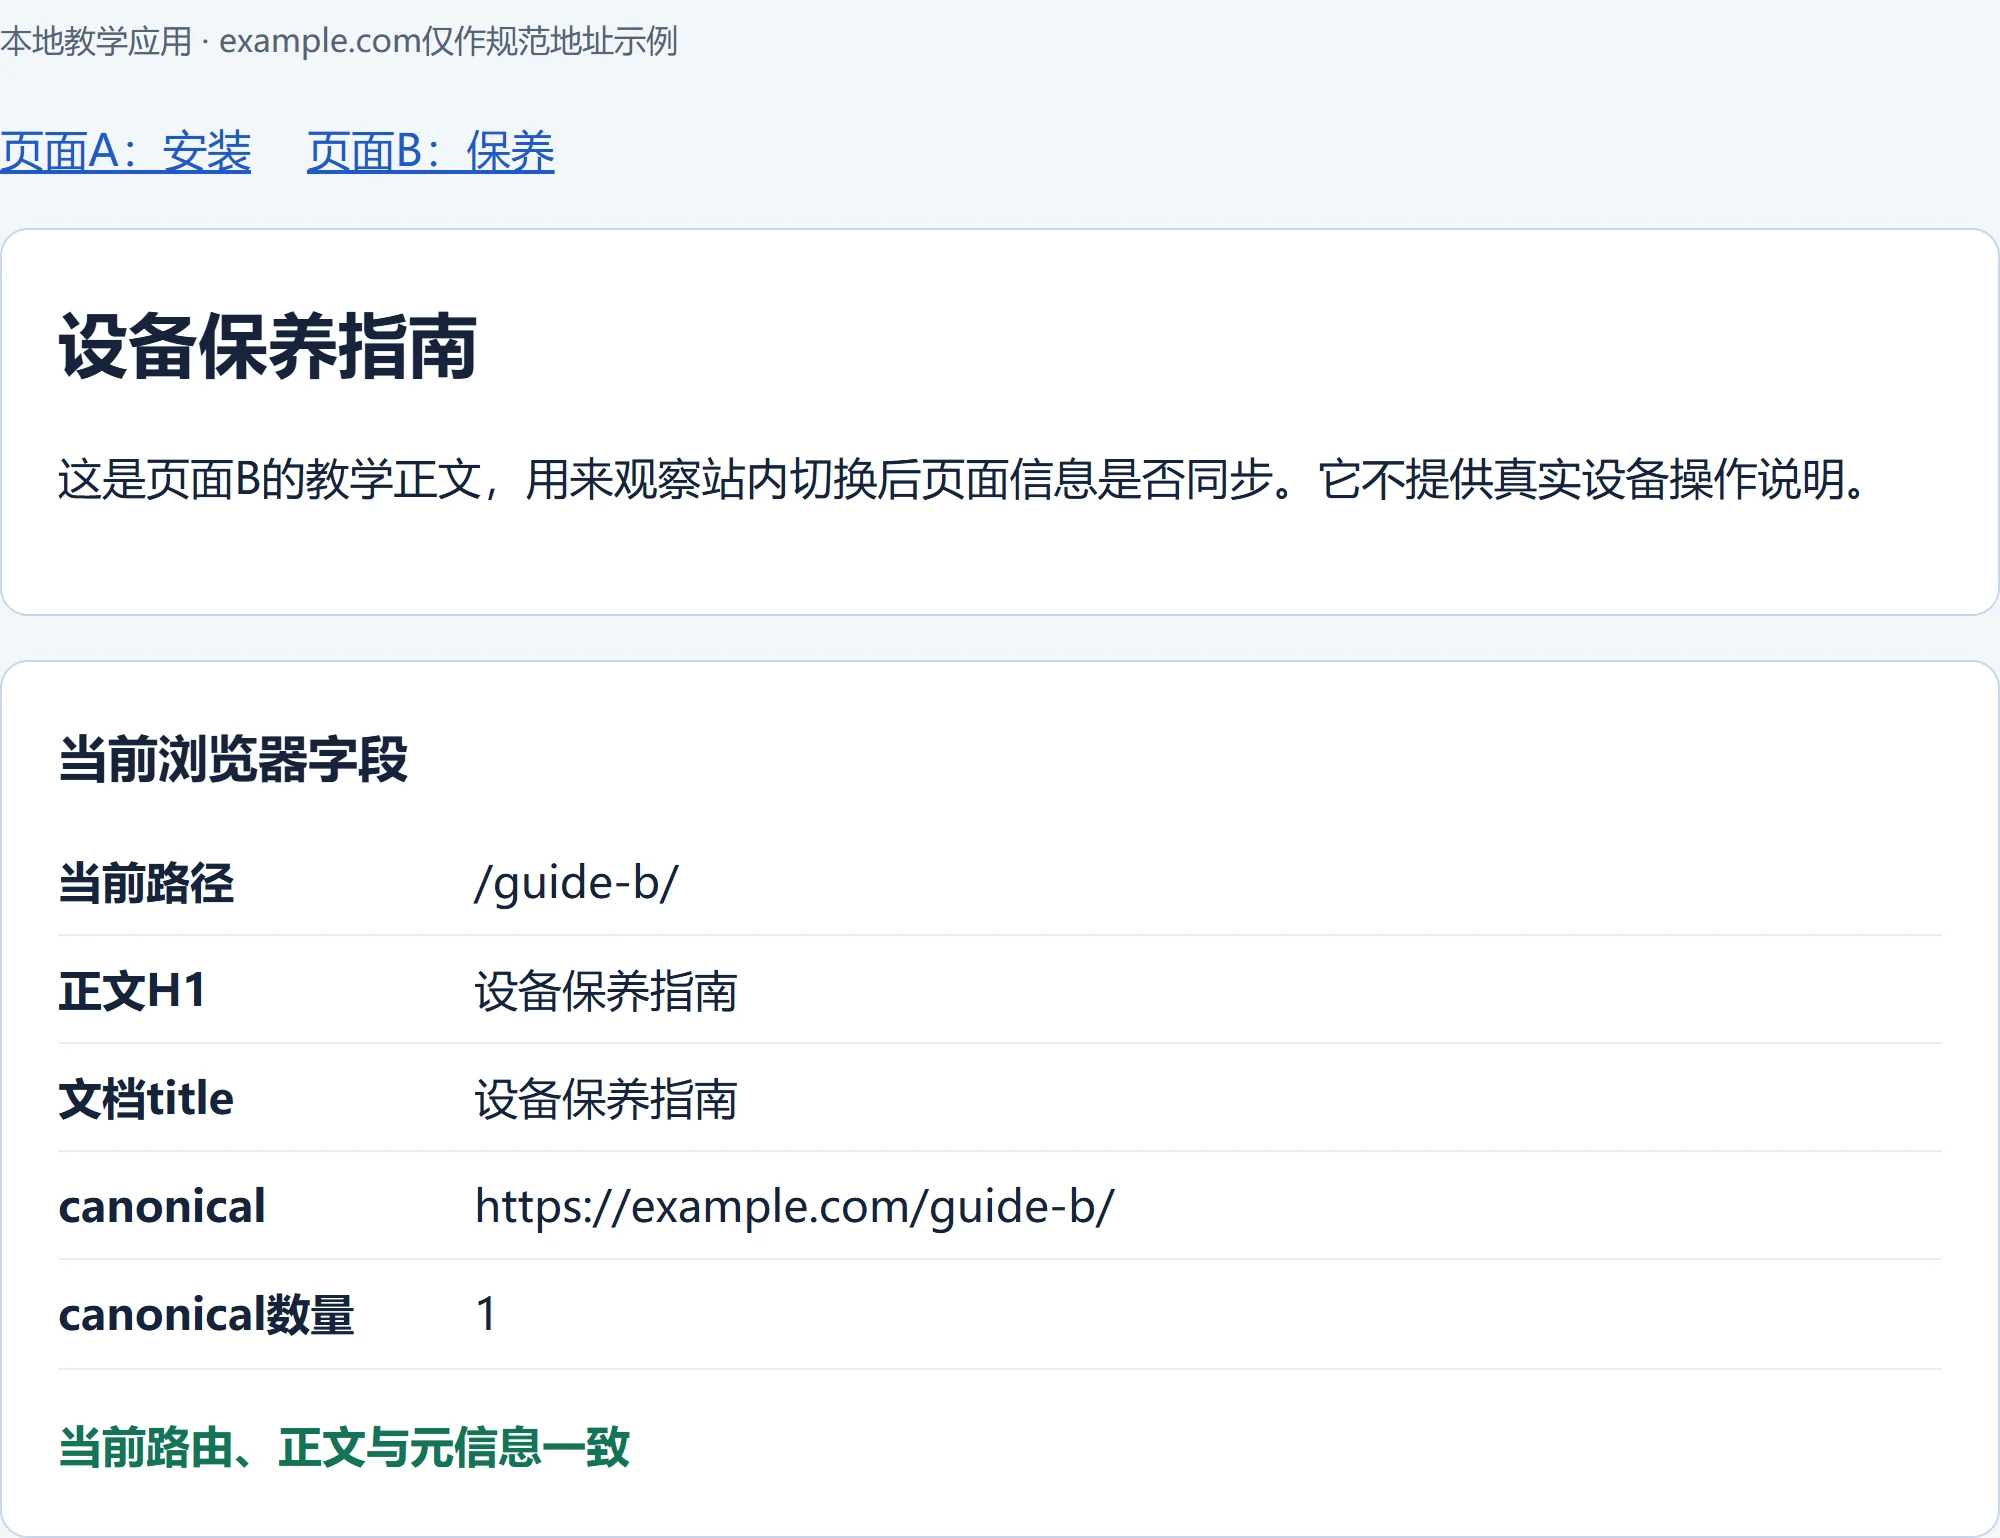
这个结果验证的是演示程序在给定条件下的行为。A较慢是人为设置,用来复现返回顺序,不是你网站的性能测量;没有运行Google渲染或比较搜索排名。真实项目仍要按自己的路由框架、数据层和元信息接口修复,不能把表中的“B”当作所有页面都应自规范的规则。
给开发的验收,要覆盖直达、回退与快速切换
可以把工单写得足够具体:从哪张A点哪个入口到B,当前哪个字段残留,何时读取;附上两次采集与失败请求,注明B本来应使用哪个规范目标。请开发明确谁提供当前页面数据、谁提交正文、谁负责title与canonical,再修改遗漏或被覆盖的更新逻辑。
完成后,按不同进入方式验证:
- 直接输入A或B,以及刷新B:真实服务器响应、正常渲染和对应规范目标一致。
- A进入B、B返回A,以及浏览器后退/前进:每次数据稳定后,正文和元信息对应当前页面。
- 慢请求与快速切换:旧结果不能把当前正文或元信息改回上一页;失败时有合适的错误处理。
- 查看真实链接与错误地址:公开页面有可识别的
href,直接访问有效页面正常,不存在的地址不能全部伪装成正常内容。
最后一项要直接打开URL检查。搜索系统需要能从链接发现并直接请求各个URL;菜单能点到,不代表那个URL单独打开就正确。框架升级、共享布局和缓存变更后,也要选使用同一机制的代表页面核对。
网站当前输出正确后,再由有权限的人用GSC检查同一个B的实际取回与渲染,结合之后的抓取记录判断Google处理了哪版。浏览器复现、Google实时测试和索引状态各有用途,不能把一张“当前title正确”的截图写成收录成功。
如果同一机制影响多种页面,把具体模板和失败进入方式列入技术SEO审计,方便开发一次修到共同来源。修复后再对照谷歌SEO完整流程安排其他任务;对渲染、URL和规范关系不熟悉,可从谷歌SEO学习路径补基础。
常见问题
H1和title必须完全一样吗?
不要求逐字相同。两者可以按页面展示与搜索辨认需要写得不同,但应准确表达当前内容。本文用同名教学值方便核对;真正要修的是B仍残留A的信息,不是强行统一所有字符。
装一个SEO组件库就能解决吗?
组件库提供管理接口,仍要接对当前路由、数据提交和已有输出。若旧组件继续写值,或异步结果仍会覆盖,新库也可能和它互相打架。先查职责与更新时序,再选实现方式。
用井号切换内容,是否只改标题就够了?
如果只是同页锚点,不需要把每段都变成独立页面。如果是希望独立搜索的不同内容,就要评估真实可发现URL与路由方案;只给#/...换一个标题,不能代替独立页面入口。Google的JavaScript说明建议这类客户端路由使用History API与真实链接。