按内容目录分析GSC数据,要从网址表searchdata_url_impression取URL,按路径归组,再加总点击与展示。CTR用总点击除总展示;平均排名用SUM(sum_position) / SUM(impressions) + 1。做目录总计时保留匿名查询行,另列匿名部分,不猜被隐藏的搜索词。
如果每天导出已经接通,SQL 算出的平均排名却和 GSC 差很多,先核对公式,以及两边用了哪些日期、搜索类型和筛选条件。常见原因是把每行平均排名再次平均,或先删空查询词再算总计。下面先按目录汇总,再用三行数据手算一次。你可以对照自己的报表,看看差别出在哪一步。
先固定一份能比较的数据
先确认导出数据已经到达。不知道哪一天的数据完整,可以按第一批BigQuery数据验收确认日志和数据;设置显示成功,不等于所选日期都已写入。
本例只汇总 www.example.com 上的 /seo/ 和 /wordpress/,搜索类型为网页。网域资源可能同时包含 shop.example.com,所以两段 SQL 都用 NET.HOST(url) 限定主机。若要同时分析商店和主站,把主机作为一列,再按主机和目录分组。否则,两站的 /seo/ 会混在一起。平铺 URL 可以另用「URL → 主题」对应表,无需为报表改网址。
运行前先定好四项:
- 实际项目、数据集与网址表路径。
- 正确GSC资源,例如
sc-domain:example.com;它不同于某篇文章URL。 - 已有完整导出的开始日和结束日。
data_date按太平洋时间划日,不以下载当天北京时间代替。 - 本次搜索类型、国家、设备和目录规则。下面合计所有国家与设备;要限定市场,目录表和下钻表都使用相同条件。
这些字段来自Google表结构说明。资源表没有单篇URL,而且位置累计字段叫sum_top_position;本篇一直使用网址表的sum_position,不要把两份数字合并成“总流量”。
把网址表按目录汇总
打开 BigQuery 的 SQL 查询编辑器。把表路径、资源、主机和日期换成实际值。下钻查询使用同一套条件。示例日期是 2026-10-25 至 2026-10-31,请选择已经完整导出的日期。
WITH base AS (
  SELECT
    url,
    REGEXP_EXTRACT(url, r'^https?://[^/]+([^?#]*)') AS path,
    clicks, impressions, sum_position, is_anonymized_query
  FROM `your-project.searchconsole.searchdata_url_impression`
  WHERE data_date BETWEEN DATE '2026-10-25' AND DATE '2026-10-31'
    AND site_url = 'sc-domain:example.com'
    AND NET.HOST(url) = 'www.example.com'
    AND UPPER(search_type) = 'WEB'
), grouped AS (
  SELECT *,
    CASE
      WHEN REGEXP_CONTAINS(path, r'^/seo(?:/|$)') THEN '/seo/'
      WHEN REGEXP_CONTAINS(path, r'^/wordpress(?:/|$)') THEN '/wordpress/'
      ELSE '其他路径'
    END AS directory
  FROM base
)
SELECT
  directory,
  COUNT(DISTINCT url) AS urls_with_data,
  SUM(clicks) AS clicks,
  SUM(impressions) AS impressions,
  SAFE_DIVIDE(SUM(clicks), SUM(impressions)) AS ctr,
  SAFE_DIVIDE(SUM(sum_position), SUM(impressions)) + 1 AS avg_position,
  SUM(IF(is_anonymized_query, clicks, 0)) AS anonymized_clicks
FROM grouped
GROUP BY directory
ORDER BY clicks DESC;
日期条件限定了读取的分区;不要先去掉它,再用结果末尾的LIMIT当作省扫描量的方法。运行前看编辑器的语法检查和预计处理量,必要时先缩到一个已有数据日。Google费用控制说明解释了查询验证与干运行的作用。若提示表不存在,检查项目、数据集与表名;提示地区或权限问题,则检查查询位置和账号权限。这里调整的是读取方式,无须改写导出原表。
结果中的ctr是比例:0.1091约等于10.91%,不是0.1091%。SAFE_DIVIDE在除零等错误时返回NULL;显示为空不能写成“平均排名第0”。函数说明
urls_with_data只统计这段报告里出现过的不同URL,不是网站已收录页数,也不是全部文章库存。同一URL可能出现在不同日期、查询、设备或其他记录中,需要汇总这些行,不能只取第一行。聚合查询指南
用三行数据,核对平均排名
用三行教学数据看公式为什么这样写。下面同一个SEO页面有两行记录,WordPress页面有一行:
| URL 路径 | 查询状态 | 点击 / 展示 | sum_position |
|---|---|---|---|
| /seo/a/ | 已知 | 10 / 100 | 900 |
| /seo/a/ | 匿名 | 2 / 10 | 0 |
| /wordpress/b/ | 已知 | 4 / 80 | 320 |
先只看/seo/。第一行平均位置是900 ÷ 100 + 1 = 10;第二行是0 ÷ 10 + 1 = 1。如果把10和1直接平均,会得到5.5,但这个算法把100次展示与10次展示当成同等重量。
正确计算是先加累计值,再除总展示:(900 + 0) ÷ (100 + 10) + 1 ≈ 9.18。这叫按展示次数加权——被看到100次的那一行,对目录结果的影响应更大。原始位置从零开始计数,报表名次从第一名开始,因此最后加1。
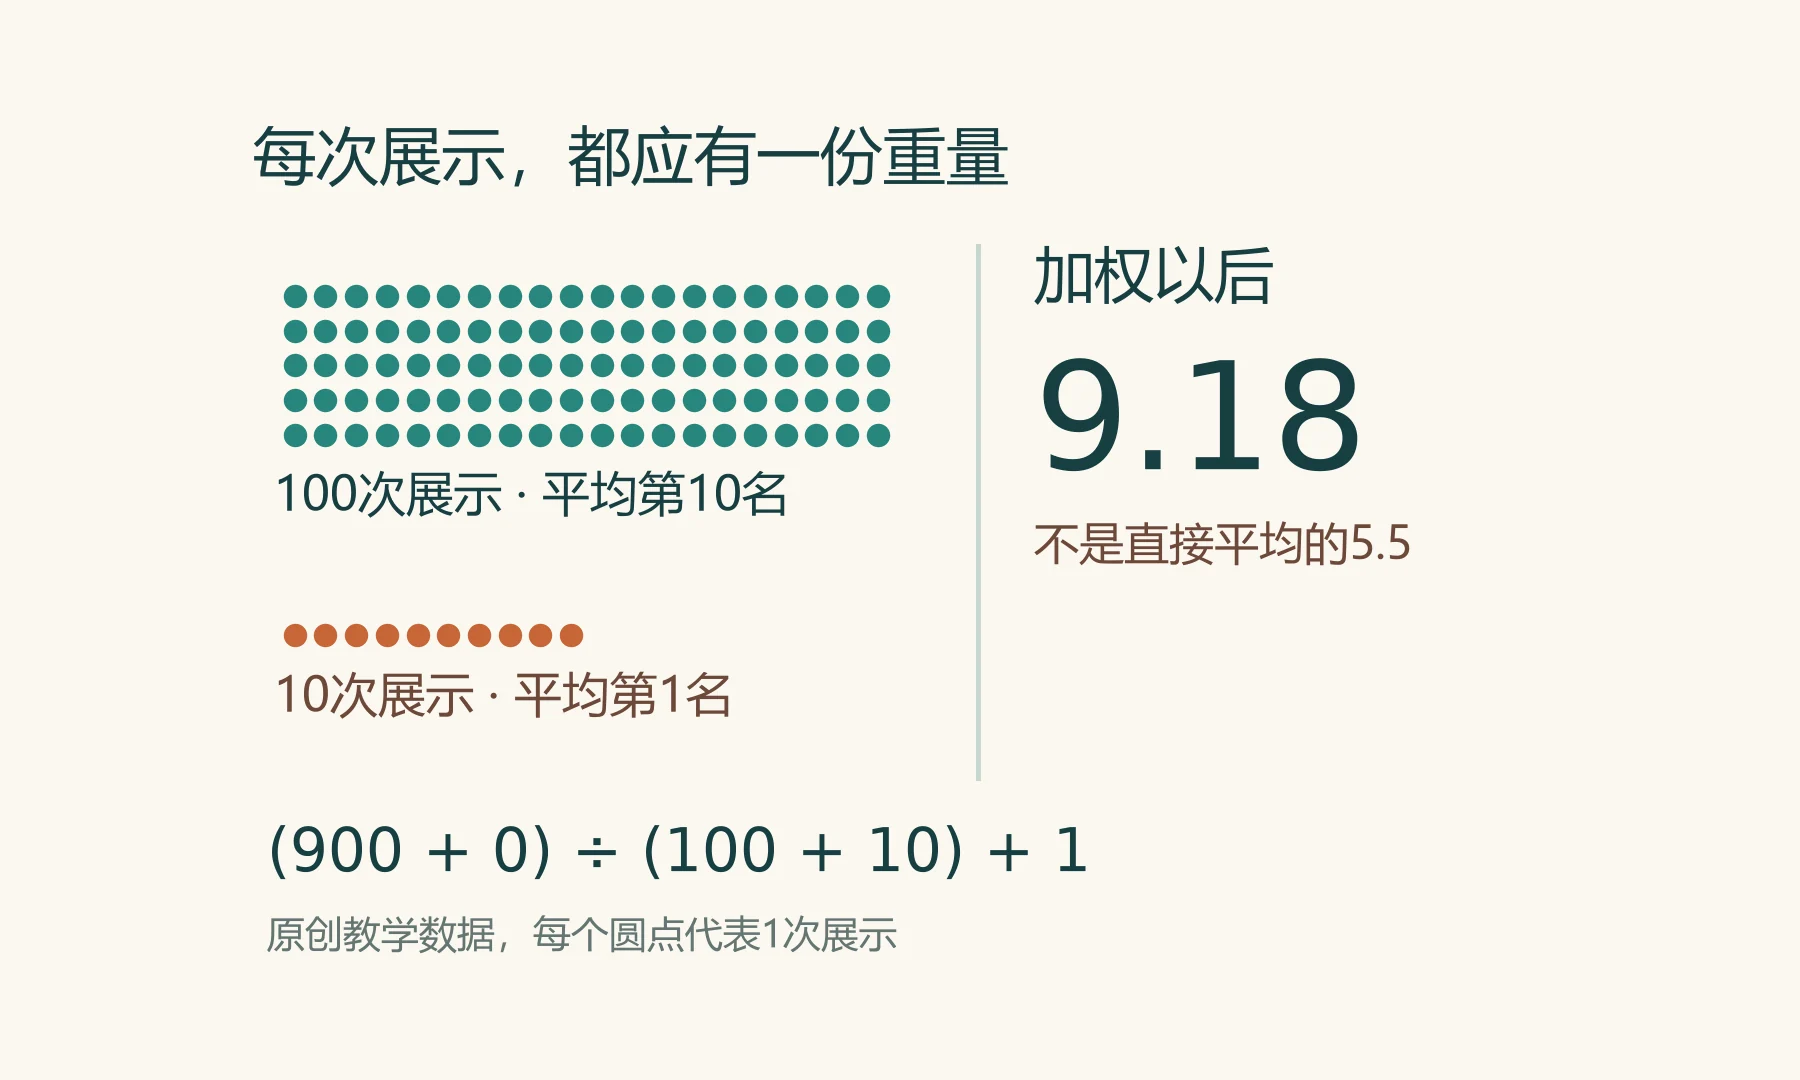
同一目录的CTR也是先合计:(10 + 2) ÷ 110 ≈ 10.91%,不能先算两行的CTR再平均。用这三行运行同样的归组逻辑,期望得到:
| 目录 | 点击 | 展示 | CTR |
|---|---|---|---|
| /seo/ | 12 | 110 | 10.91% |
| /wordpress/ | 4 | 80 | 5.00% |
| 目录 | 有数据 URL | 平均排名 | 匿名点击 |
|---|---|---|---|
| /seo/ | 1 | 9.18 | 2 |
| /wordpress/ | 1 | 5.00 | 0 |
注意,SEO目录有两行数据,但只有一个不同URL。COUNT(*)得到的行数不能用作页面数量。同一个例子里,点击和展示要加总,URL要去重,排名要按展示加权。三种计算回答的问题不同,不能都用一个平均数解决。
匿名查询:指标保留,具体词无法还原
上例匿名行贡献了2次点击、10次展示。若为了清理“空关键词”把它删掉,SEO目录就只剩10次点击、100次展示;这时你算的是已知查询部分,不再是该目录的全部可得指标。
匿名意味着查询文字受到隐私保护,不等于这一行的点击和展示都是无效值。目录汇总不需要知道它具体搜了哪个词,所以代码没有用query != ''或query IS NOT NULL过滤,而用is_anonymized_query另列匿名点击。
如果任务改成“哪些具体查询带来点击”,可以只分析已知查询,但应同时保存另一个未经该过滤的总计。不要把匿名2次点击分给已经看见的词,也不要写成“漏了2个关键词”:点击次数与关键词数量不同。
这部分能说明可见范围,不能恢复被隐藏的文字。可以在报表旁标明“目录指标含匿名查询,具体词表不含匿名文字”,读表时就能看懂总计和具体词表为什么有差别。
选中一个目录,再找具体URL
目录表用于挑选要继续看的区域。真正修改内容时,还要找到是哪张页面发生变化。以下沿用相同表、资源和日期,只下钻/seo/;需要限定国家设备时,这里也同步增加条件。
SELECT
  url,
  SUM(clicks) AS clicks,
  SUM(impressions) AS impressions,
  SAFE_DIVIDE(SUM(clicks), SUM(impressions)) AS ctr,
  SAFE_DIVIDE(SUM(sum_position), SUM(impressions)) + 1 AS avg_position
FROM `your-project.searchconsole.searchdata_url_impression`
WHERE data_date BETWEEN DATE '2026-10-25' AND DATE '2026-10-31'
  AND site_url = 'sc-domain:example.com'
  AND NET.HOST(url) = 'www.example.com'
  AND UPPER(search_type) = 'WEB'
  AND REGEXP_CONTAINS(
    REGEXP_EXTRACT(url, r'^https?://[^/]+([^?#]*)'),
    r'^/seo(?:/|$)'
  )
GROUP BY url
ORDER BY impressions DESC;
下钻沿用上一个查询的日期、国家和设备条件。若汇总时加过筛选,下钻也要复制同样的条件,否则明细可能加不回目录总数。按上面的教学数据,这一步应返回/seo/a/的12次点击和110次展示。若你自己得到多个页面,先选一张有足够展示、且业务上重要的URL,再看它对应的已知查询和实际内容。
例如页面获得不少展示却少有人点击,下一步要核搜索意图、标题与结果页竞争情况;不要直接把整篇文章加长。如果点击减少,还要看展示、市场和查询构成是否变了。按SEO页面诊断顺序把数字转成具体核查动作,而不是用目录均值替每张页面下结论。
目录均值改善也不自动证明刚才的改文有效:可能只是排名较好的新页面获得更多展示。若要判断某次调整的效果,应另外设计前后比较与合适的对照。
有足够页面和数据、准备验证一项具体改动时,再按SEO分组测试与点击变化解释安排测试组和对照组。目录报表能找出哪个栏目变了。要判断变化是不是这次修改造成的,还得看没做同样修改的页面同期表现如何。
结果对不上,先查字段、范围、路径和关联表
如果数字与预期差很多,先看下面四处。它们会直接改变合计和分组结果。
- 字段用错。 本文用网址表的
sum_position。复制资源表公式时,不能只换表名却留下sum_top_position,更不能把两种汇总再相加。 - 比较范围不同。 日期缺一天、Web和图片混算、国家设备不一致,都会让结果不可直接比较。先保留固定条件和成功导出日期,再查内容表现。
- 路径规则不适合自己。
/seo、/seo/能进入本例SEO组,/seo-tools/不会。平铺URL、语言目录或业务自定义分类,需要改规则或使用映射表;不凭标题猜分组。 - 关联表让行重复。 一个URL在主题映射里出现两次,关联后点击可能翻倍。先让每个URL只有一个本次主分组,再汇总;对照关联前后的点击总数。如果刻意允许多主题归属,要说明各主题合计不能再当全站总计。
把查询代码、日期与市场条件、分类规则、执行时间和结果一起保存。过几周再做一轮时,才能区分“网站变了”和“统计方法变了”。
常见问题
查不到任何结果,网站就是零流量吗?
先核表路径、资源字符串、完整数据日期和搜索类型,再看导出日志是否成功。如果查询权限不足,或所选日期尚未完成导出,先解决权限或缩小到已有数据的日期。确认查询成功且范围无误后,才能把空结果记为该范围内没有可用记录。
展示是0,平均排名该写多少?
不要填0名或1名。本文的安全除法会留下NULL,表示这个分母下无法计算该平均值;报表可显示“无可计算值”,不要为了图表完整而编一个排名。
按目录做月度比较就够了吗?
目录表可以发现变化,但仍要核数据是否完整、比较期长度和市场是否一致,再下钻到URL与查询。新旧页面构成改变时,目录平均排名也会变化;它不能单独证明某项SEO操作造成了增长。