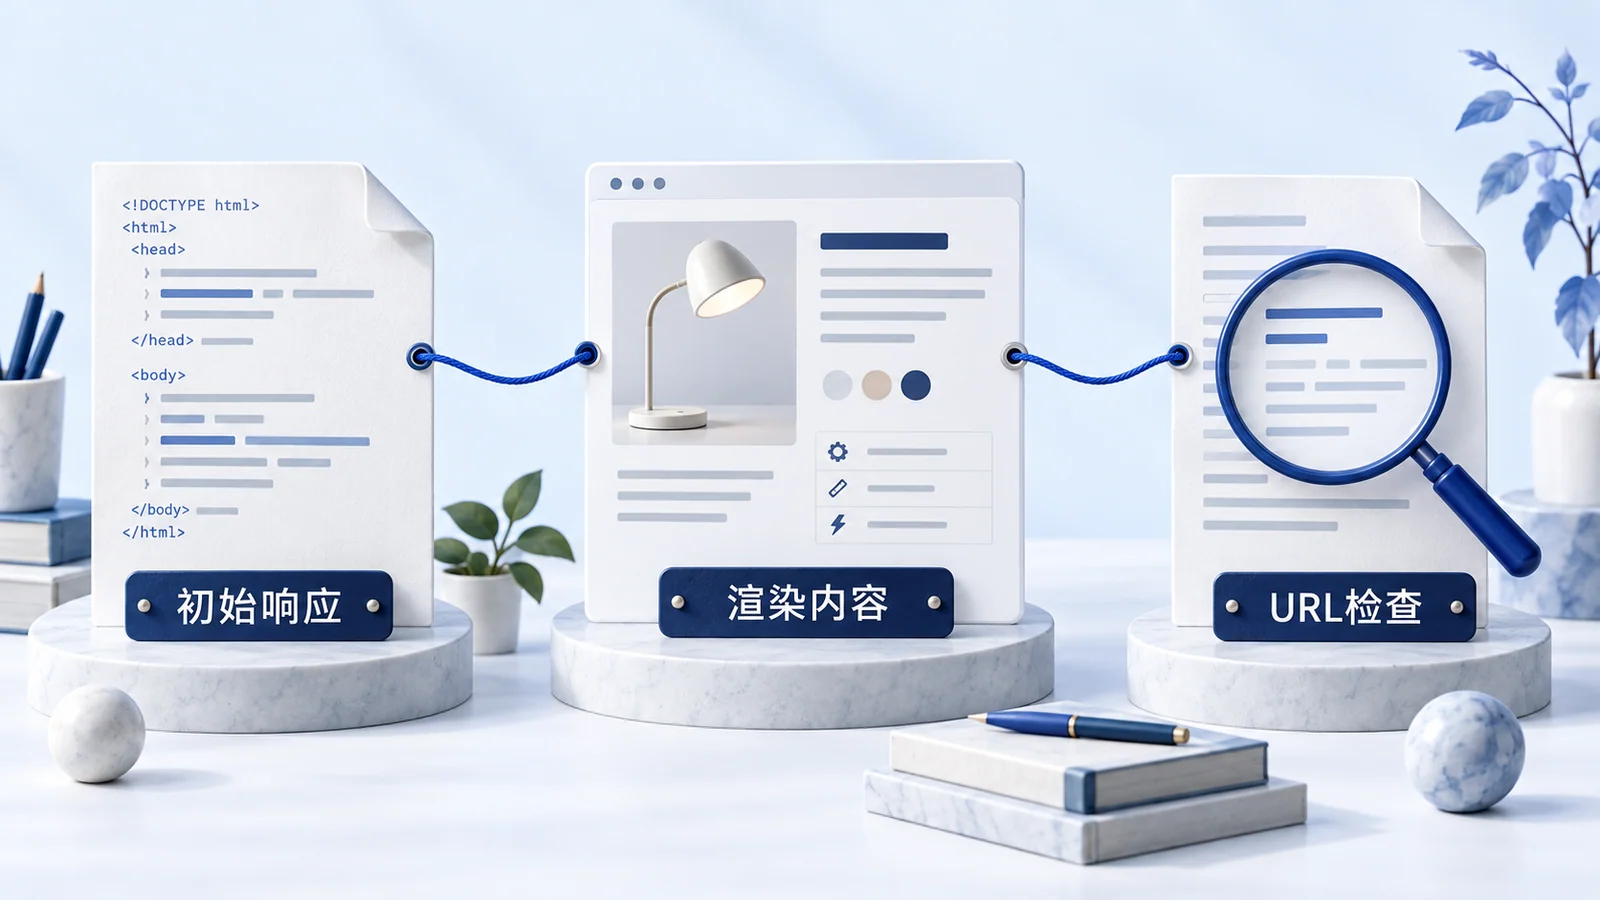
产品页在浏览器里能一直往下看,Google取得的内容却像少了后面的规格和使用限制。遇到这种情况,先保存原始HTML,量未压缩的 HTML,并找到缺失段落在文件里的位置。段落接近抓取上限时,要看它能否完整落在上限以内。浏览器显示正常、网络面板里的压缩传输量很小,都不能单独证明Google拿到了完整内容。
截至2026年10月26日,Google现行文档写明:Googlebot用于Google搜索抓取时,普通受支持文件的前2MB会被取回,PDF为前64MB;限制按未压缩数据计算。这个规则值得检查,但它解释不了所有“正文没被看到”。大多数普通文章不需要因为篇幅长就删内容。Googlebot抓取限制说明
先判断你是否真的需要查体积
你维护的是一个长产品页:前面有导航、轮播、配置器,后面才是适用条件。编辑能在页面底部找到“仅适合室内使用”,SEO同事却发现Google的测试内容里缺了这部分。开发者打开网络面板,看见传输量只有几KB,于是认为文件大小可以排除。
这里有两个还没核实的前提:测试时取得的是不是同一版本的页面;几KB指的是压缩后的传输量,还是展开后的HTML。没有分清,就可能一直修改后半段文案,却没碰到挡在它前面的巨大数据块。
先按实际情况分流:
| 当前观察 | 接下来优先检查什么 |
|---|---|
| 原始HTML很大,缺失内容位于很后面 | 未压缩体积、关键句的位置、前置内联数据 |
| 原始HTML很小,关键内容只在脚本执行后出现 | JavaScript渲染及相关资源能否取得 |
| 取到的是登录页、验证码或错误提示 | 先核当前访问条件;验证码可按200挑战页排查确认实际响应 |
| 原始HTML已有完整正文,Google测试也能看到 | 索引选择、内容价值等后续环节 |
判断应以这次从目标URL实际取得的HTML为依据。只凭“网页很长”就归因抓取限制,会把排查方向带偏。若问题发生在脚本执行后,可转看JavaScript正文抓取与渲染排查;更广泛的入口在抓取与索引故障排查。
2MB约束的是哪个文件
可以把网页理解成一份HTML文件和它引用的多份资源。浏览器最终呈现的长页面,是这些内容共同工作的结果;Googlebot的文件限制并不是把屏幕上所有图片、样式和文字加成一笔总账。
看未压缩HTML,不只看网络传输量
同一个HTML经过gzip等压缩后,传输量可能小很多。解压后仍然很大的文件,不会因为传输时省了流量就变成很小的HTML。尤其是大量重复字符、重复模板和重复数据,压缩后的数字容易让人低估实际体积。
Google的抓取字节说明在 2026 年 10 月 29 日的更正中说明,这项预算计入 HTTP 响应头。下面的本地测量只计算响应正文,不包含HTTP响应头,因此只能判断内容是否明显靠前或靠后。目标句开头接近上限时,把句尾及后续必要条件也定位到原始文件。抓取预算还计入响应头,正文不应卡着 2 MB 放关键信息。
外部资源分别取得,内联内容留在当前文件里
通过独立URL引用的CSS和JavaScript会分别抓取;直接塞进HTML的大段脚本、JSON状态数据、base64图片,则占用当前HTML的体积。把文件挪到外面也不代表工作完成:外部资源还得能访问,并在需要时正确执行。
2MB与PDF的64MB来自Googlebot当前文档。其他Google爬虫可能有不同限制,不能把这里的数字推广到所有机器人,也不要沿用旧文章里的15MB来判断当前Google搜索的HTML抓取。
保存原始HTML,找到关键句的位置
检查时先选一句独特、确实应该被读取的正文,例如“L2适用室内干燥环境”。不要选“产品介绍”这种出现十几次的短词,否则找到的可能只是导航或页面数据里的另一份副本。
在一个新建的本地检查目录中保存文件,避免覆盖已有资料。Windows可使用下列命令,把示例地址换成实际要检查的URL:
curl.exe --compressed -D response-headers.txt -o page-source.html "https://example.com/products/l2/"
先打开response-headers.txt核对HTTP状态。若是3xx,确认跳转后的正式地址,再对那个地址取样;若是4xx、5xx或验证码页面,先查访问异常。只有确认保存的是目标产品HTML,再测字节,避免把跳转提示或错误页当正文。--compressed会让curl解压支持的响应编码,后续量的是保存后的内容。
同时记录URL、时间和访问条件。这份文件只代表此次curl请求;网站若按身份、地区或缓存返回不同版本,还要与Google的实时测试和相关请求记录对照,不能直接把它当成Googlebot已经取得的内容。
电脑已有Python时,把下面代码存为check-html.py,与page-source.html放在同一个目录,在该目录运行python check-html.py。它读取字节,不用编辑器的字符数估算:
from pathlib import Path

data = Path("page-source.html").read_bytes()
target = "L2适用室内干燥环境".encode("utf-8")
start = data.find(target)
print("HTML正文总字节:", len(data))
if start == -1:
    print("未找到连续的目标字节")
else:
    end = start + len(target)
    print("目标句起始偏移:", start)
    print("目标句结束偏移(不含):", end)
    print("目标句字节数:", len(target))
也可以把原始 HTML 和要查的完整段落交给开发者,请对方返回正文总字节数,以及该段第一字节和末字节后一位的位置。
偏移从 0 开始。结束偏移是目标句最后一个字节的下一位:正文预算若是 B 字节,只有结束偏移 ≤ B 时,整句才在这份文件的前 B 字节内。例如,教学边界取 2,000,000,句首是 1,999,990、长度是 26 字节,结束偏移就是 2,000,016,句首虽然在边界内,整句已经跨过边界。这只是本地演示;Google 的抓取预算还计入响应头,不能把这条演示边界当作实际阈值。先确认文件编码;上面的代码按 UTF-8 查找,也不能拿浏览器 Elements 里的执行后 DOM 替代原始响应。
找不到目标句时,先查原始 HTML
「未找到连续的目标字节」只说明原始文件里没有完整匹配。可能是文字被标签拆开、字符经过转义、文件不是 UTF-8、取到了另一版,或正文由 JavaScript 生成。
先搜索更短的独特词,检查周边源码,再与浏览器中的可见内容对照。还没完成这些核对,就不能写下“Google截断了正文”。原始文件里不存在的句子,也谈不上测它在该文件中的后部位置。
同一段正文,为什么压缩很小仍靠后
为把这个差别算清楚,我制作了一份本地HTML样本:在正文前放入240万个重复的A字符,作为本例不需要的内联JSON填充;后面保留同一句“L2适用室内干燥环境”。然后删除这段填充,再测一次。
下表是本次实际运行结果。它只说明这个样本的字节关系,没有向Google提交页面,也没有模拟Google完整抓取流程。
| 测量项 | 保留填充 | 删除本例不必需的填充 |
|---|---|---|
| HTML响应正文 | 2,400,248字节 | 181字节 |
| gzip压缩后的正文 | 2,601字节 | 175字节 |
| 目标句的起始字节偏移 | 2,400,197 | 130 |
| 目标句的结束偏移(不含) | 2,400,223 | 156 |
| 完整文件是否包含目标句 | 包含 | 包含 |
这组对照的重点是:第一份文件传输时可以压到约2.6KB,解压后的正文却有240万多字节;目标句确实存在,但排在很后面。第二份没有删掉答案,只移除了前面不需要的填充,句子的位置便前移了。
真实网站的数据通常没这么夸张,也不会全是重复字符。不能拿这次压缩率当成你的网站压缩率。这个实验能支持的结论是:传输小与未压缩文件小是两件事,测量关键内容的位置比猜测更有用。
先检查正文前的重复模板和内联数据
回到产品页,先看是什么占用了前面的空间。若页面底部有客户做选型所需的适用条件,删掉它虽然能减字节,却会让人更难选购;如果留下的仍是大量无用内联数据,抓取问题也未必得到妥善处理。
数据重复,先找重复从哪里生成
常见情况是同一份商品资料被放进多套状态对象,或者页面明明只展示一款商品,HTML却携带了整个目录的数据。让开发者确认哪些数据是当前页面必需的,再减少输出或按需加载。不要直接删掉看起来很长的JSON,价格切换、库存和配置器可能依赖它。
大段内联资源,按依赖关系处理
排查base64图片、大段重复样式和脚本。适合独立提供的资源可以考虑外置,但修改后要检查资源响应、权限、加载顺序和实际交互。把问题从HTML移到一个加载失败的脚本里,并不能改善Google和客户看到的内容。
WordPress里,Minify、合并和延迟执行也会产生不同结果。若需要调整这些开关,可以结合CSS和JS压缩设置的区别逐项处理,不要一次把所有“优化”选项打开。
必要信息的位置,也值得重新检查
标题、必要的页面描述、canonical和与页面有关的结构化数据,应在合理的位置输出。主要答案也不应该被大量重复导航和无关模板内容挤到最后。调整顺序时保留正常阅读体验,不能为了把代码提前,就让用户在页面顶部面对一大堆无关内容。
改后重新核对HTML,再看Google处理
修改后重新请求相同 URL,保留新文件和测量时间。比较正文总字节、目标句的起止位置,以及随后会改变选择的限制条件是否完整。只前移一句结论,仍让必要条件留在预算之外,读者依然拿不到完整答案。
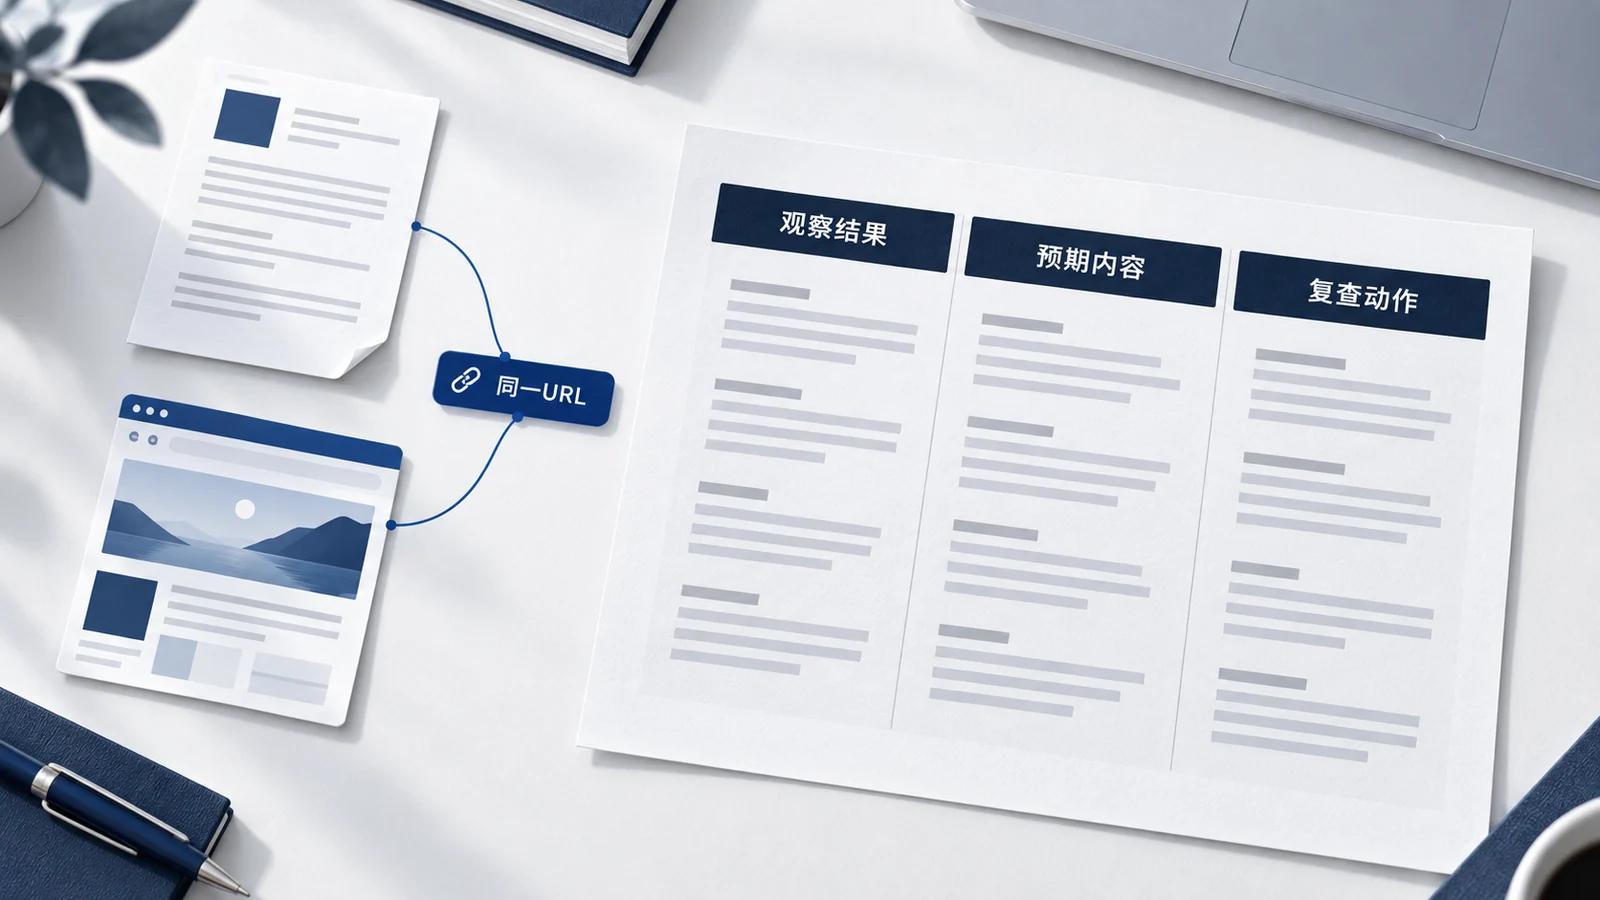
把URL、时间、原始文件、浏览器内容和下一步复查放在同一份记录里,开发者才知道你比较的是哪次请求返回的HTML。教学图展示的是这种记录关系,不是Google截断或恢复抓取的截图。
随后检查产品选择、价格、表单和手机阅读。当前HTML和页面功能都确认正确后,再用Search Console的实时测试核对Google现在能取得的页面内容;历史索引报告需要等待后续处理,不能因为它没有立刻变化就连续重复改版。
如果前后文件都很小,目标段落也能被Google测试读取,就应结束体积这条排查。把精力转到页面SEO检查及内容是否真正满足搜索问题上,比反复压缩几个空格更有价值。
常见问题
HTML超过2MB,是不是整张页面都会被丢弃?
Google文档描述的是达到限制后停止取回,把已经取得的部分交给后续处理。不能把它理解成整页自动消失,也不能保证被取回的部分一定收录。应核对重要内容有没有处于可取得的部分。
网站启用了gzip,就不用检查HTML体积了吗?
仍需要按未压缩数据检查。压缩主要减少传输量,未必减少解压后的文件大小。本地样本里2,601字节的gzip数据,展开后的HTML正文就是2,400,248字节。
长文章都要拆成几页,才能让Google读完吗?
不用。先量实际文件。普通文章的文字长度和HTML体积不能画等号;若体积主要来自重复模板和内联资源,优先处理这些来源。是否拆页,应取决于读者任务能否独立完成,不能只因为屏幕很长就拆散答案。