403表示服务器拒绝访问。在 Cloudflare 的 AI Crawl Control(AI爬虫控制)里把 OAI-SearchBot 设为 Allow(允许),其他安全规则仍可能拦住它。先查某一张公开页面的失败请求,找到实际处理它的规则,再调整对应条件。Cloudflare官方排查说明
例如,团队想让ChatGPT搜索读取一篇泵维护指南,已选Allow,却看到403。这时要查指南那一次请求,不是把全站安全保护关掉。如果只是ChatGPT没引用文章,还没查到失败请求,也不能先认定是403。
先确认放行的是谁、哪一页
OAI-SearchBot是OpenAI用于ChatGPT搜索的网站爬虫。GPTBot涉及可能用于模型训练的内容访问;ChatGPT-User是用户触发的访问。它们用途不同,放行其中一个不等于另外两个也放行。OpenAI爬虫说明和Cloudflare机器人分类都区分这些名称。
写下目标完整网址,比如 https://example.com/guides/pump-x2-maintenance/,再用未登录浏览器打开。指南应该公开,而客户专属下载区可能本来需要登录,两者不能套同一规则。
请维护者同时看 robots.txt,这是告诉爬虫哪些路径允许访问的文件。若它禁止这条路径,或旧链接跳去了登录页,先处理这些安排。WAF是网站的安全防护系统,改它不能自动消除登录或爬虫规则问题。
OpenAI爬虫说明还说明,被禁止的站点仍可能以导航链接出现。看到一个链接,不能证明正文已成功抓取。
到安全事件里,找到这次失败
登录Cloudflare,选这个网站,打开 Analytics → Events。这里是Security Events,即安全事件。先把时间调到失败发生时,再点 Add filter 添加目标主机名Host和路径Path,应用筛选。官方界面说明
例如目标为 example.com 的 /guides/pump-x2-maintenance/。别拿同域另一个页面的事件解释这张指南,也要确认时间用的是UTC还是北京时间。
找到候选行后,读这几项:访问的地址、时间、User Agent、来源IP、Action,以及处理服务或规则。User Agent是访问者自报的程序名;Action是Cloudflare做了什么。Block表示拦截,Managed Challenge表示要求完成验证,不等于已经确认最终HTTP状态一定是403。
看到OAI-SearchBot字样,还需核来源。请维护者结合Cloudflare的验证信息和OpenAI当前公布的IP范围判断。IP是请求来自的网络地址;只靠自报名称不可靠。用工具模仿这个名称也只是模拟,不能当成OpenAI真实爬虫。
安全事件不是完整请求清单,可能采样,保留时间也因套餐不同。没有找到时先扩大合理时间或检查主机筛选,再到Security Analytics请求分析或HTTP日志补查。原服务器没有记录,也可能是Cloudflare在前面已处理,不能直接说机器人没来。
找到命中规则,再请负责人调整
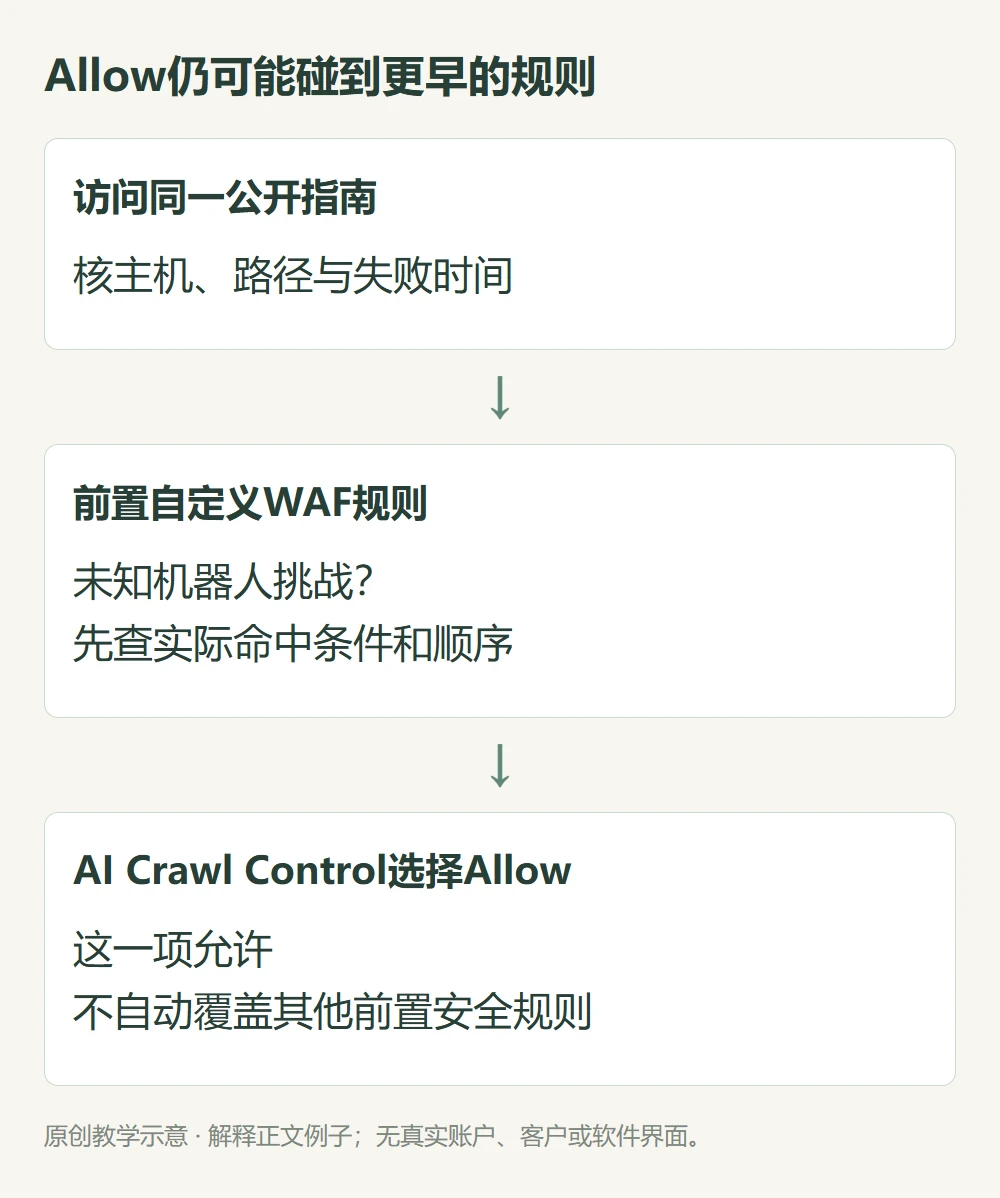
假设同一指南的可信请求被“未知机器人挑战”规则处理,先请安全负责人在Security rules里找到对应自定义规则,查看条件和顺序。Cloudflare说明,自定义WAF规则可能比AI Crawl Control规则更早执行,Allow不会自动覆盖它。
改动应针对已经查到的冲突:哪个机器人、哪条公开路径、哪条规则条件。保留原设置,以便回退;不要只因为网页想被引用就对后台、客户资料或所有机器人放行。没有权限的运营,把网址、时间和事件交给规则负责人即可。
Skip动作可以跳过指定安全功能,但能跳过什么有产品限制。不能把它理解为所有拦截的万能开关。变更后若无关请求也绕过保护,恢复原规则再缩小条件。
最后请维护者核请求的实际状态和正文。事件告诉你哪层采取动作,HTTP响应告诉你最终收到什么,两者需要对应同一次访问。
泵维护指南的排查,走到什么结果
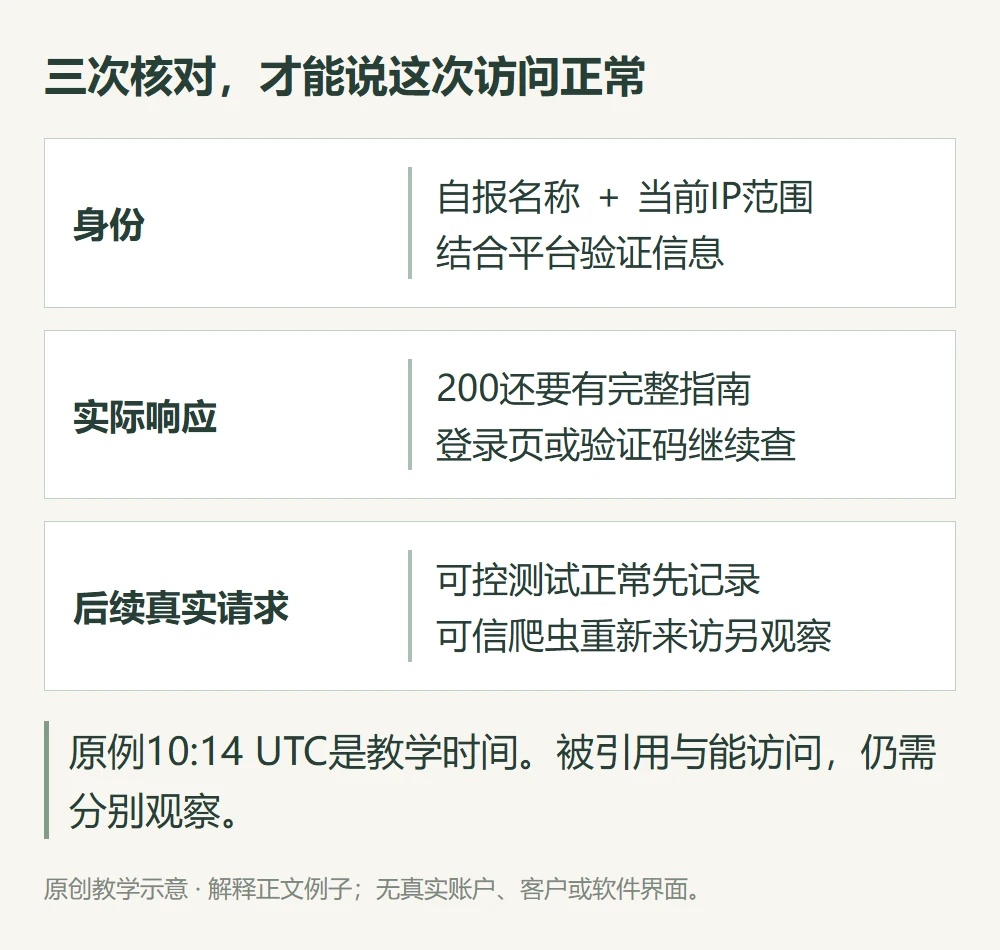
下面是虚构教学,不是客户日志。10:14 UTC,一次访问泵X2指南的事件自报OAI-SearchBot,Action为Managed Challenge,命中旧的“未知机器人挑战”规则。
第一步先核身份和最终响应。身份尚不明确时,写“疑似请求”,不扩大例外。若维护者确认是目标搜索爬虫,且这条规则确实阻止公开指南,才进入修改。
第二步由安全负责人调整这条规则的匹配条件,保留对其他流量的保护。保存后先用可控请求访问同一网址,确认页面能返回预期内容。这个测试证明当前配置可用,仍不能证明OpenAI已经重新来过。
第三步等后续可信爬虫请求,再看它是否获得完整指南。若返回200但正文是验证码、登录页或空页面,继续查,不能写成功。若完整正文已返回,就可以记“这次访问正常”;还没有可信新请求,就记“当前测试正常,真实爬虫请求待观察”。
另外两种情况别硬套上面流程:没有可信拦截事件时先补请求记录;实际返回500或520等服务器错误时,查原服务器或连接问题。它们都不要求继续放宽机器人规则。
网页能访问以后,再查是否被引用
可信请求已取得200和完整正文,而ChatGPT仍未引用,先停止改WAF。固定一个这篇指南能回答的问题,再观察ChatGPT实际列了哪些来源,比较页面资料和发现入口。AI品牌问题采样方法解释了怎样避免只测一次就下结论。
记录使用的产品入口、问题、时间和相关账号或地区条件。访问成功与选源是两件事,内容能读到不保证每个问题都会引用它。
OpenAI提到robots规则变化可能需要约24小时调整。这是策略更新的提示,不是“24小时后必引用”的期限。其他平台的令牌也有各自用途,Google-Extended说明不能直接套成OpenAI的规则。
这次检查最终应说清一个结果:已找到并修正具体规则;仍缺可信请求;或网页已可访问,接下来查内容与搜索选源。负责人据此继续,不用反复切Allow。
如果问题牵涉现有网站的访问、页面输出与内容入口,可先看WordPress网站服务,或带公开网址、失败时间和相关事件联系跨境YOUNG。先判断网站哪个环节需要处理,再安排维护或SEO工作。
常见问题
显示Allow,就能确认实际请求没被挡吗?
不能。它只说明AI Crawl Control这项允许访问,更早的安全规则或原服务器仍可能拒绝。查同一页面的实际事件、规则和响应。
模仿OAI-SearchBot测到403,可以直接加白名单吗?
先不要扩大规则。名称可以伪造;模拟可发现配置问题,但需另核真实请求身份和命中规则。查不到真实请求,就保留待观察。
网页返回200,为什么ChatGPT仍没引用?
先确认200里是完整公开正文。若真实爬虫已拿到内容,访问这一步已正常,接下来检查具体问题、内容及实际来源;继续放宽WAF不能保证引用。