Anthropic 在 2026 年 9 月 22 日发布 Claude Opus 5.5。标准 API 输入和输出价格分别从 Opus 5 的每百万 token 5/25 美元降到 4/20 美元,缓存读取从 0.50 降到 0.20 美元。Anthropic 还称,新模型在其典型工作负载中的单任务成本约低 40%,同时改善了复杂任务和文字表达。发布公告
对内容团队,值得试的不是“把所有稿子换个模型重写”,而是需要同时核多份来源、修正旧文事实、处理例外条件的稿件。最终比较单位应是一篇通过编辑验收的稿件:模型花费、编辑返工时间、漏掉的事实和发布风险都算进去。已经把 Opus 5 接入自动化流程的团队,还要先做接口兼容检查;仅在 Claude 网页版写稿的编辑不需要改 API 代码。
降价是真的,省下多少取决于任务
| 标准 API 费用,每百万 token | Opus 5 | Opus 5.5 | 本次变化 |
|---|---|---|---|
| 普通输入 | 5 美元 | 4 美元 | 降 20% |
| 输出 | 25 美元 | 20 美元 | 降 20% |
| 缓存读取 | 0.50 美元 | 0.20 美元 | 降 60% |
例如一项任务消耗 100 万普通输入和 20 万输出,不使用缓存、收费工具或重试:Opus 5 为 5+0.2×25=10 美元;Opus 5.5 为 4+0.2×20=8 美元。这笔同 token 用量的账节省 20%,不能写成 40%。后者是 Anthropic 在自己的典型任务上同时计入 token 用量变化得出的估算,实际内容流程可能不同。价格与测试口径
新闻真正改变的是高复杂度任务的试用门槛。过去团队可能只把较贵模型留给最后一轮改稿;新价格让“读来源、指出矛盾、写修订稿、再复查”的完整一轮更容易进入预算。但省下的两美元若换来十分钟额外编辑,经济上未必划算;反过来,若它减少了漏改和返工,总成本也可能比单价变化更明显。这是决策逻辑,目前不是本站测出的效果。
Anthropic 公布的 Terminal-Bench 4.0 等成绩来自指定测试条件,说明新版在一些专业任务中更强;它不能推算中文 SEO 稿的通过率。发布方还展示了更直接、更易读的回答示例。对编辑来说,这意味着可以把“读完来源后给出可追溯的修订建议”列为试点任务,而非直接宣布新模型能取代审稿。官方评测说明
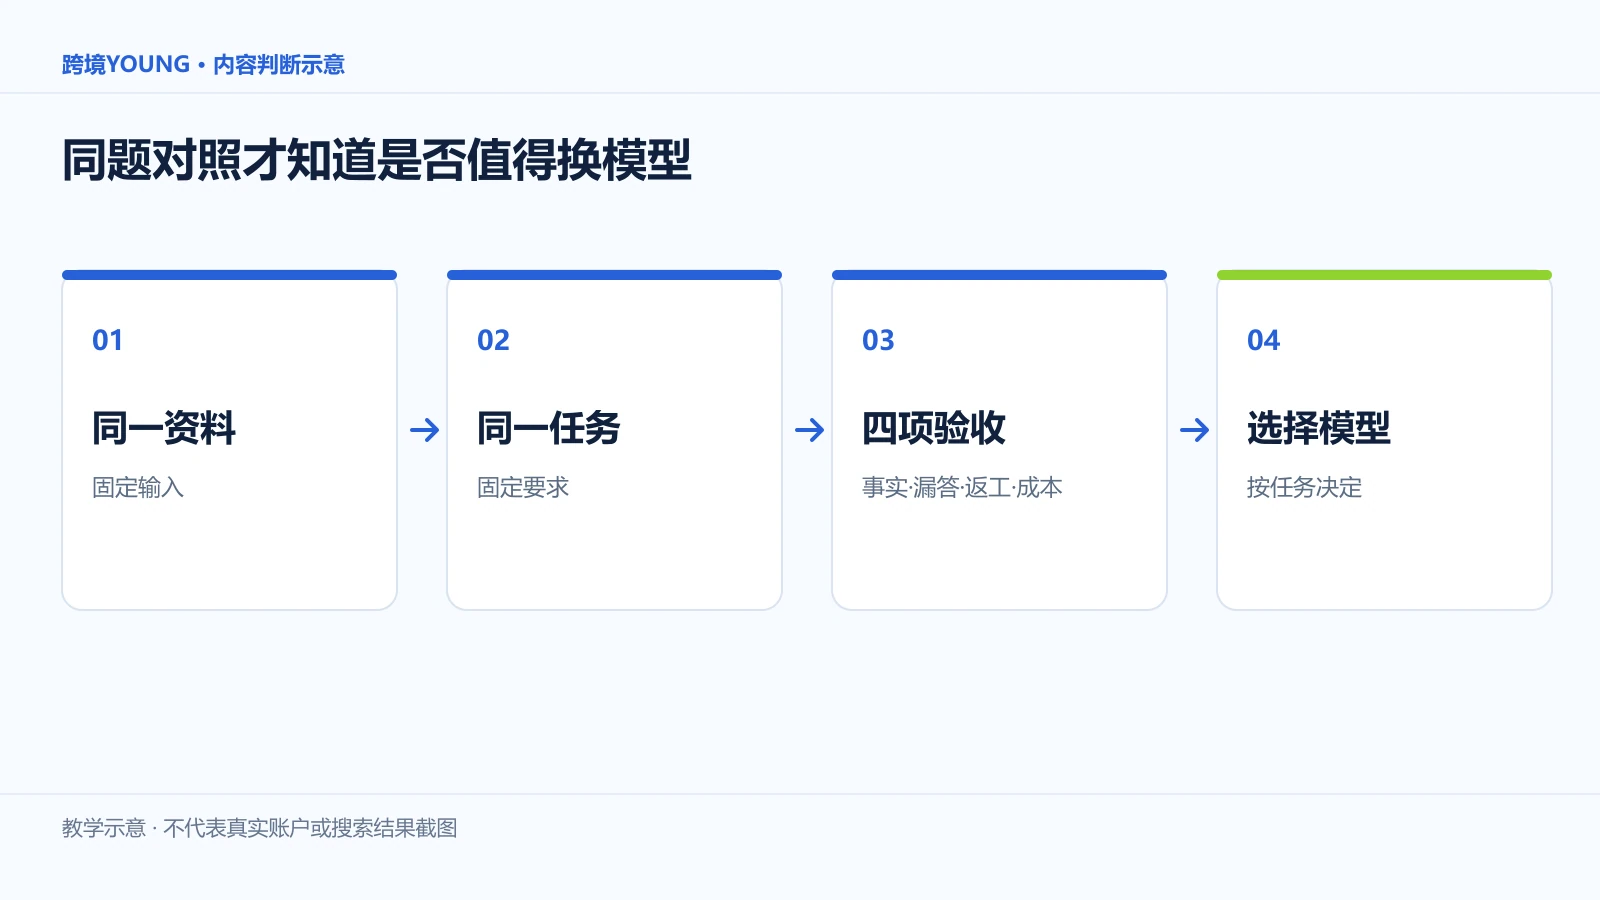
用同一篇旧稿检验“少返工”是否成立
选一篇已有编辑修改记录的旧文,给 Opus 5 和 5.5 完全相同的旧稿、官方来源和任务:“找出过期或超出来源范围的句子,写出可发布的替换段落,标明未改的依据。”固定资料后,差异才可能来自模型,而不是一边拿到了更多信息。
假设旧稿声称“Google 的新本地商家展示适用于所有地区”,这是一句教学用的错误旧句,不是本站发现的真实客户案例。Google 对聚合展示的说明限定了用户所在区域:相关展示面向欧洲经济区(EEA)的搜索用户;聚合商还涉及 Vertical Search Service 资格、必要数据和质量要求。仅有 LocalBusiness 结构化数据,并不能让所有站点进入该展示。
合格的修订段落可以写成:
Google 的聚合展示目前面向欧洲经济区用户的部分酒店、交通、商品和本地商家查询。它主要让符合条件的垂直搜索服务在搜索结果中展示相关选项;是否有资格参与,还取决于服务类型、审核、数据提供和质量要求。直接提供商品或服务的商家应另看 Google 对供应商展示的说明。站点添加 LocalBusiness 标记并不能单独保证进入聚合展示。
这段改写的价值在于把行动对象分开:EEA 搜索用户是展示对象,垂直搜索服务是聚合单元的潜在参与者,直接商家走另一条说明。编辑验收时不必奖励模型写得长,应核三个结果:地区没有被抹掉、聚合商与直接商家没有混成一种资格、来源未支持的“保证展示”已删除。若两款模型都做到,再比对编辑改动分钟数和完成这篇稿件的实际费用;若 5.5 漏掉关键范围,单价再低也不能作为切换理由。
把改稿结果放回网站,而不是留在对话框
SEO 团队验收模型时,还要检查改动有没有到达读者实际看到的页面。沿用上面的 EEA 案例,新闻正文若已改对,但谷歌 SEO 文章中心的摘要卡仍写“全球商家都能参加”,读者仍会从站内入口得到错误结论。一次完整交付至少核对三处:旧文的标题与首段是否限定 EEA 和参与角色,相关聚合页的摘要与锚文本是否继续夸大适用范围,旧稿指向新指南的内链是否把目录站和直接商家的任务接错。这里说的是需要核查的页面位置,并非声称本站现有页面存在这些错误。
可以给模型一张小工单:输入是旧文 URL、官方文档版本、该文在站内出现的摘要位置;输出是“原句—证据—替换句—需同步的页面”。编辑先按高质量 SEO 内容的验收标准审事实与读者任务,再在公开页面逐项点测。若只给出一段漂亮的新正文,却没有找出仍在误导读者的入口摘要,这次试点应记为未完成页面更新,不能算一篇已交付的合格稿。
对新发布的模型新闻也一样:它应当链接到能继续解决问题的常青内容,而不是只相互推荐其他模型发布稿。若读者关心高频任务的成本,站内的批量内容缓存费用案例承接账单计算;关心稿件是否可发布,则进入质量验收页。这样模型更新才会改变已有内容工作流,而非只增加一条新闻 URL。
已接 API 的团队,先查迁移能否跑通
Opus 5.5 的模型 ID 是 claude-opus-5-5,但对已有 API 程序,替换模型名并不总能正常运行。Anthropic 迁移指南列出四类会破坏旧请求或对话处理的变化:
| 旧流程使用了什么 | 切换前要核什么 |
|---|---|
| 关闭 thinking 或手动设置旧式 thinking 预算 | 5.5 的思考不能关闭;移除旧字段,按任务选择 effort。旧请求会返回 400。 |
| 强制某个工具必须被调用 | tool_choice 的 any/tool 类型不受支持;改为 auto,配合严格工具定义或结构化输出。 |
| 在多模型间回放同一段对话 | thinking 块与模型、对话有关;工具回合保留并按类型处理这些块,测试备用模型路径。 |
| Claude API 或 Google Cloud 的旧 computer_20251124 工具 | 迁到新 computer_toolset_20260801,并核对代理循环;Amazon Bedrock 的旧工具处理方式不同。 |
还有一种不报错的变化:原先显示在两次工具调用之间的进度文字,可能进入默认不展示内容的 thinking 块。若内容团队的后台把这些文字当作“正在核对来源”的进度提示,升级后界面可能突然安静,但任务仍在运行;迁移指南给了展示更新的设置。一次回归测试至少覆盖普通改稿、来源查询、工具调用与错误回退,而不是只试一个“你好”。没有接 API 的团队可以跳过这节代码排查。
是否切换,拿同类稿的合格交付成本说话
把三到五篇代表性旧稿分成同一类型,例如“Google 更新解读”。每篇固定来源、旧稿、字数范围和编辑验收要求,再分别用 Opus 5 与 5.5 跑。记录四项:事实或适用范围遗漏、编辑修改分钟数、总模型账单、最终是否通过验收。这不是要求把新闻稿自动发布,而是把“更省”落到可比较的交付物。
若新版在事实验收相同的前提下让编辑少返工,且接口回归通过,可先迁移这类任务。若它只让首稿更顺,却仍漏掉重要范围,就保留原审核流程。短标题改写、固定字段整理等窄任务也不一定需要 Opus 级模型;可再与轻量模型比较,不必因为新品发布而把所有请求都升级。跨模型选择的另一种口径见本站 GPT‑6 Sol 更新解读,但不同厂商的发布方基准不能直接当同题 A/B。
Anthropic 表示 Opus 5.5 已进入 Claude、Claude Platform 和部分云平台;API 实际模型名及配额以账户和所用平台为准。fast mode 的输入/输出价格是每百万 8/40 美元,应与标准模式分开记账。平台与模式说明
常见问题
Opus 5.5 的价格比 Opus 5 低 40% 吗?
普通输入、输出单价各低 20%,缓存读取低 60%。约 40% 是 Anthropic 对典型任务总成本的估算;用自己的输入、输出、缓存和返工数据才能算实际差额。
只在 Claude 网页版写稿,也要改迁移参数吗?
不用。thinking、tool_choice 和 computer use 的兼容问题针对已有 API 程序。网页版编辑仍应对比同源改稿的事实遗漏与修改时间。
更高的官方基准能证明中文 SEO 文章更好吗?
不能。基准测试任务、提示词和验收条件与中文站文章不同。用相同来源和编辑标准比较合格稿,才知道团队是否受益。