把合格的首选URL拆成多个子地图,每份同时满足不超过50,000条URL、解压后不超过52,428,800字节,再用sitemapindex列出这些子文件。先看 CMS 是否已经生成多个子文件。确实需要手工拆分时,先保存一份确定的网址清单。拆分后,用这份清单检查有无漏项、重复或新增,并核对子文件解压后的大小,上线先放齐子文件,再切换索引入口。
如果你看到“文件太大”,却数出只有三万条URL;或者压缩成.gz后很小,仍然无法通过,通常是只检查了条数,没有检查解压后的XML大小。继续改文件名或反复提交,不能解决这个问题。
先分清:单个文件的上限,不是全站上限
这两个限制针对单个地图文件,不是说网站最多只能有五万页。
| 文件 | 里面列什么 | 数量限制 | 大小限制 |
|---|---|---|---|
普通URL地图,根标签为urlset | 网页的完整URL | 最多50,000条URL | 解压后不超过52,428,800字节 |
地图索引,根标签为sitemapindex | 子地图的完整URL | 最多50,000份子地图 | 解压后同样不超过52,428,800字节 |
Google的地图制作说明给出50MB和50,000条的限制;Sitemaps协议明确将这里的50MB写为52,428,800字节。检查程序应使用这个实际字节值,不凭编辑器里的字符数估算。
gzip可以节省传输量,但不会放宽解压后的限制。一个原始XML超过上限,即使压缩后只有几百KB,也仍需要拆。反过来,一份只有几千条的地图完全可以存在,不必为了“用满额度”将所有栏目合在一起。
先找生成器,再固定要拆的那批地址
WordPress已经自动分卷,就继续由它维护
打开当前地图索引,看子文件是否已按文章、页面或编号分开。由系统或SEO插件生成的地图,通常应交回同一个生成器处理,不要再手工维护一套内容相同的静态文件。
例如,WordPress原生地图的每份URL数默认是2000,可以通过相应过滤器调整;这是WordPress自身的默认值,不是Google只能接受2000条。插件产生多份子地图,也不等于网址重复或生成出错。
若自动文件确实超限,先查生成器设置、扩展功能和实际输出。普通WordPress站怎样找到真实入口、提交并排错,可以沿XML Sitemap生成与三层排查操作;本篇继续处理需要大清单分卷的情况。
自己导出时,先保留一个稳定快照
输入应是你希望被索引的首选公开地址,而不是把数据库中的所有记录都拿来切文件。先排除不应独立索引的预览、登录、明确下线和重复版本,保留实际最终URL;脚本不会因为能写XML,就自动知道哪一个是正确规范版本。
导出期间还要避免清单自己变化。例如从API分几页取文章,第一页取完后又插入新文章,后面的分页可能位移,导致重复或漏取。可用生成器支持的稳定排序、快照或固定范围导出,并记录时间与输入总数,再对这份清单拆分。
原文件若包含可靠的lastmod、图片或视频扩展,选择分卷工具时确认会保留哪些字段。不能因为工具只保留loc,就把其他内容静默丢掉;也不要把所有页面的lastmod改成今天,只为让新文件日期整齐。没有可靠修改时间时,省略可选日期比编造更合适。
每写入一个条目,同时检查两条限制
已有XML,可以先用适配格式的分卷工具
先确认输入是列网页的urlset,不是列子文件的sitemapindex。以SitemapKit分卷器的说明为例,需要填写文件将来的公开目录、设置每卷条数,再导入URL地图,取得子文件和索引包。它会检查条数与未压缩大小;但其说明明确不复制图片、视频、新闻扩展,不适合直接替换依赖这些扩展的文件。
使用这类工具时,可以按四步处理:
- 保存原文件,确认它的格式、URL总数及必须保留的字段。
- 填真实计划公开的目录,条数上限不得高于50,000;更低的工作上限也可以。
- 生成后解开文件包,检查索引引用的是你准备上传的子文件地址,而不是工具的默认示例域名。
- 按后文的方法重新解析、比集合并检查大小,再安排上线。工具提示成功,不代替自己的结果核验。
SitemapKit的功能与限制来自其公开说明,未作上传测试。下面用本地程序生成两批示例文件,检查分卷规则。
自己写导出程序,判断应发生在加入条目之前
给维护者的规则可以写成下面这样。这是流程伪代码,不是可直接运行的完整程序:
准备XML头、根标签和结束标签,计算它们的UTF-8字节。
逐个读取已确认、去重的首选URL:
    将URL正确写成一个XML条目,完成实体转义,再编码为UTF-8。
    如果加入后会超过50,000条,或整个文件会超过52,428,800字节:
        结束当前非空子地图,开始新文件。
    加入当前条目,更新数量与字节数。
最后结束仍有内容的子地图,再生成引用所有子文件的索引。
要算的是实际输出XML的字节,包括开头、结束标签和转义后的内容。不能先把五万条网址拼完,再只看网址本身有多长。中文与英文字符的UTF-8字节可能不同,网址编码和XML转义也会改变输出长度。
例如URL中确实需要保留&时,XML文本需要写成&,解析后再还原为原来的URL。这与把中文或其他字符做URL百分号编码是两件事;不能为了过XML检查,随意改网页地址或新建一个slug。协议还要求单个loc值少于2048个字符。
写程序时还要处理装不进空卷的条目。若一条网址加上它的图片或视频扩展就已经超出大小上限,继续开新卷也放不下。记录该网址和超出的字段,回到生成器处理,避免把超限文件交给搜索引擎,也别悄悄丢掉这条网址。输入恰好分完时,则不需要再写一份空子地图。
索引列子地图,子地图才列网页
假设文件计划放在同一站点根目录,公开关系应像这样:
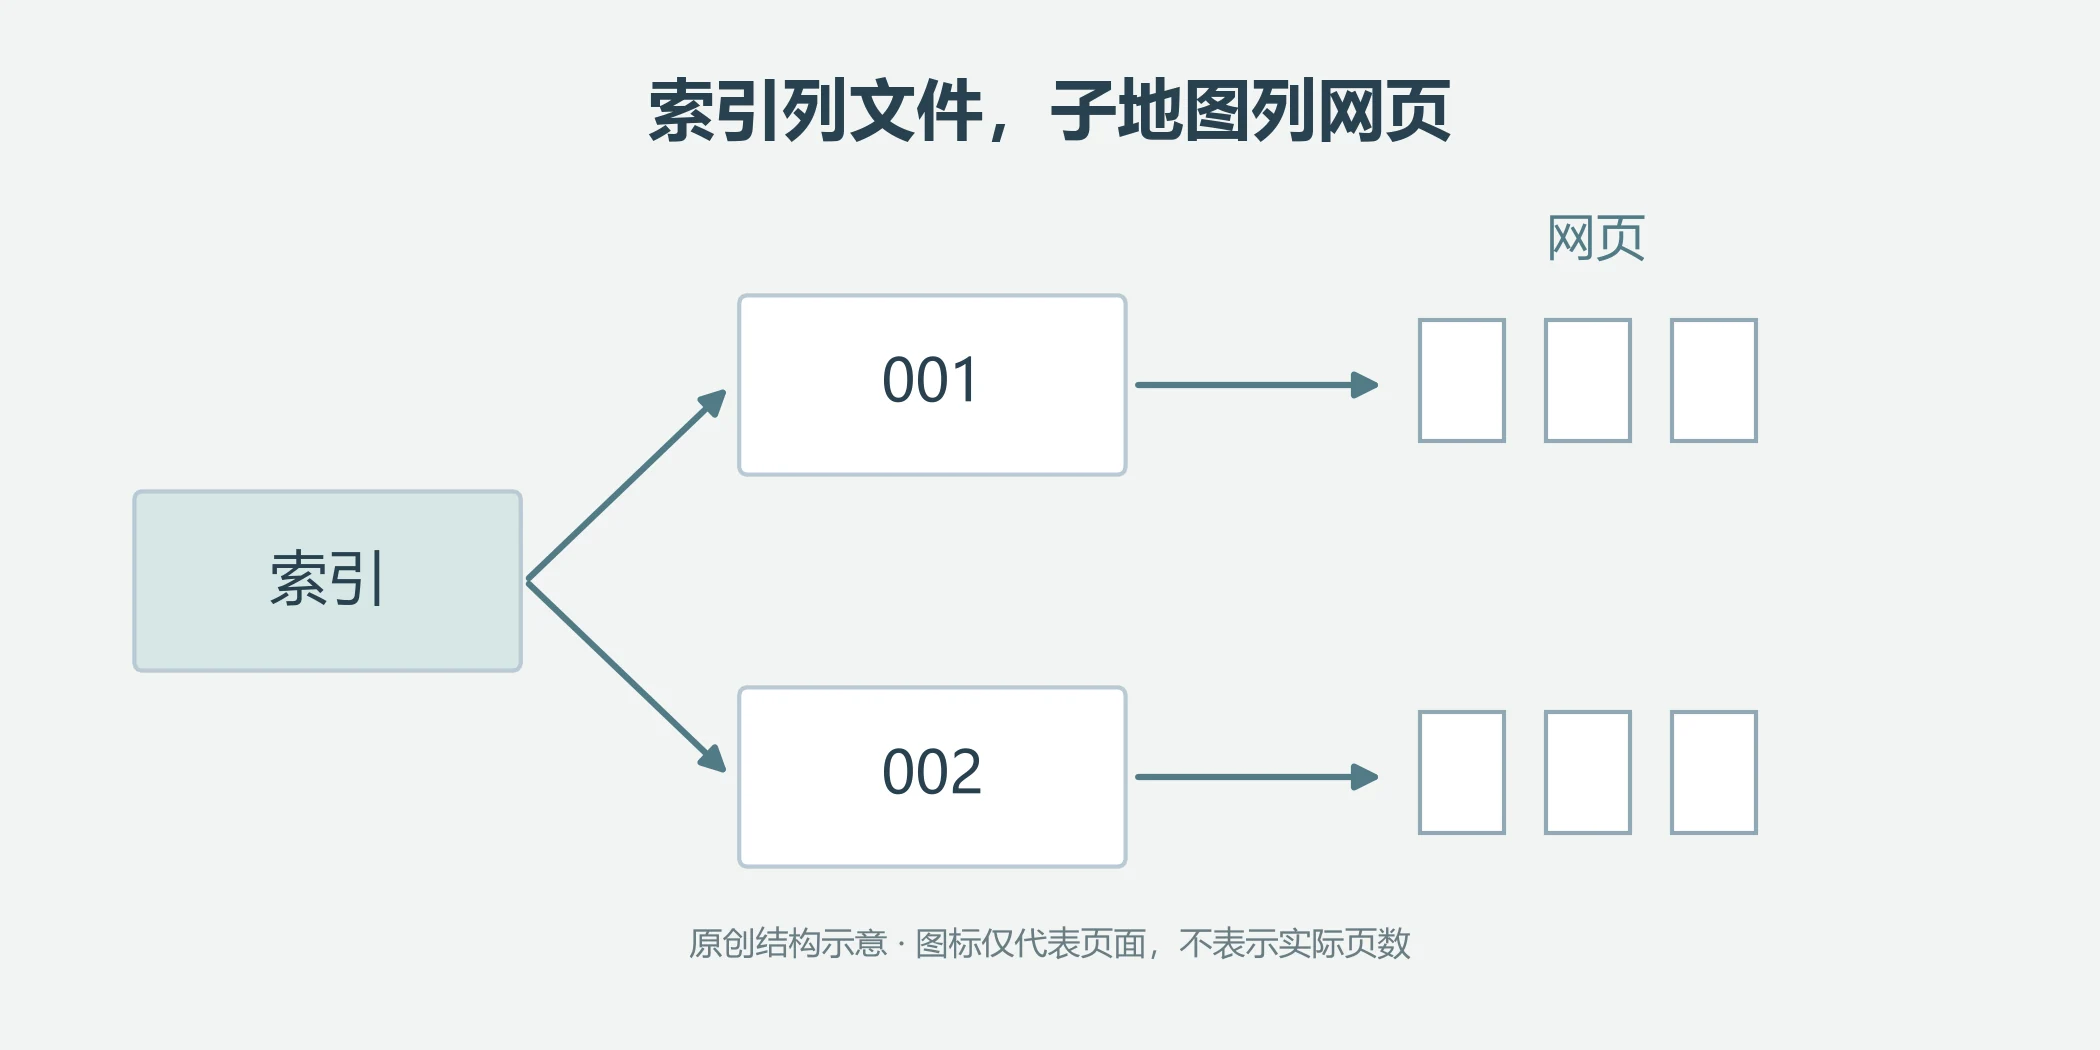
/sitemap-index.xml
    → /sitemap-001.xml → 这一卷的网页URL
    → /sitemap-002.xml → 另一卷的网页URL
索引文件中的条目是子地图地址:
<?xml version="1.0" encoding="UTF-8"?>
<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <sitemap><loc>https://example.com/sitemap-001.xml</loc></sitemap>
  <sitemap><loc>https://example.com/sitemap-002.xml</loc></sitemap>
</sitemapindex>
其中一份子地图才列页面,例如:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url><loc>https://example.com/articles/000001/</loc></url>
</urlset>
不要把文章URL直接写进索引的sitemap/loc,也不要把另一个地图索引当成普通子地图层层套下去。按照Google的索引文件要求,普通同站方案中,子地图应在索引同一目录或更深的位置;跨站提交需要另外配置,不在这个根目录示例范围内。
索引条目的lastmod若提供,表示相应子地图文件的修改时间,不是把所有网页都标成同一个更新时间。本文示例没有可靠历史日期,所以不添加这个可选字段。
两批文件,分别在哪个上限触发拆分?
下面实际生成并解析了两批自拟教学文件。域名和地址都是示例,不是本站文章库存,也没有逐一访问这些虚构页面。目的只是验证数量、字节和拆分前后的URL集合。
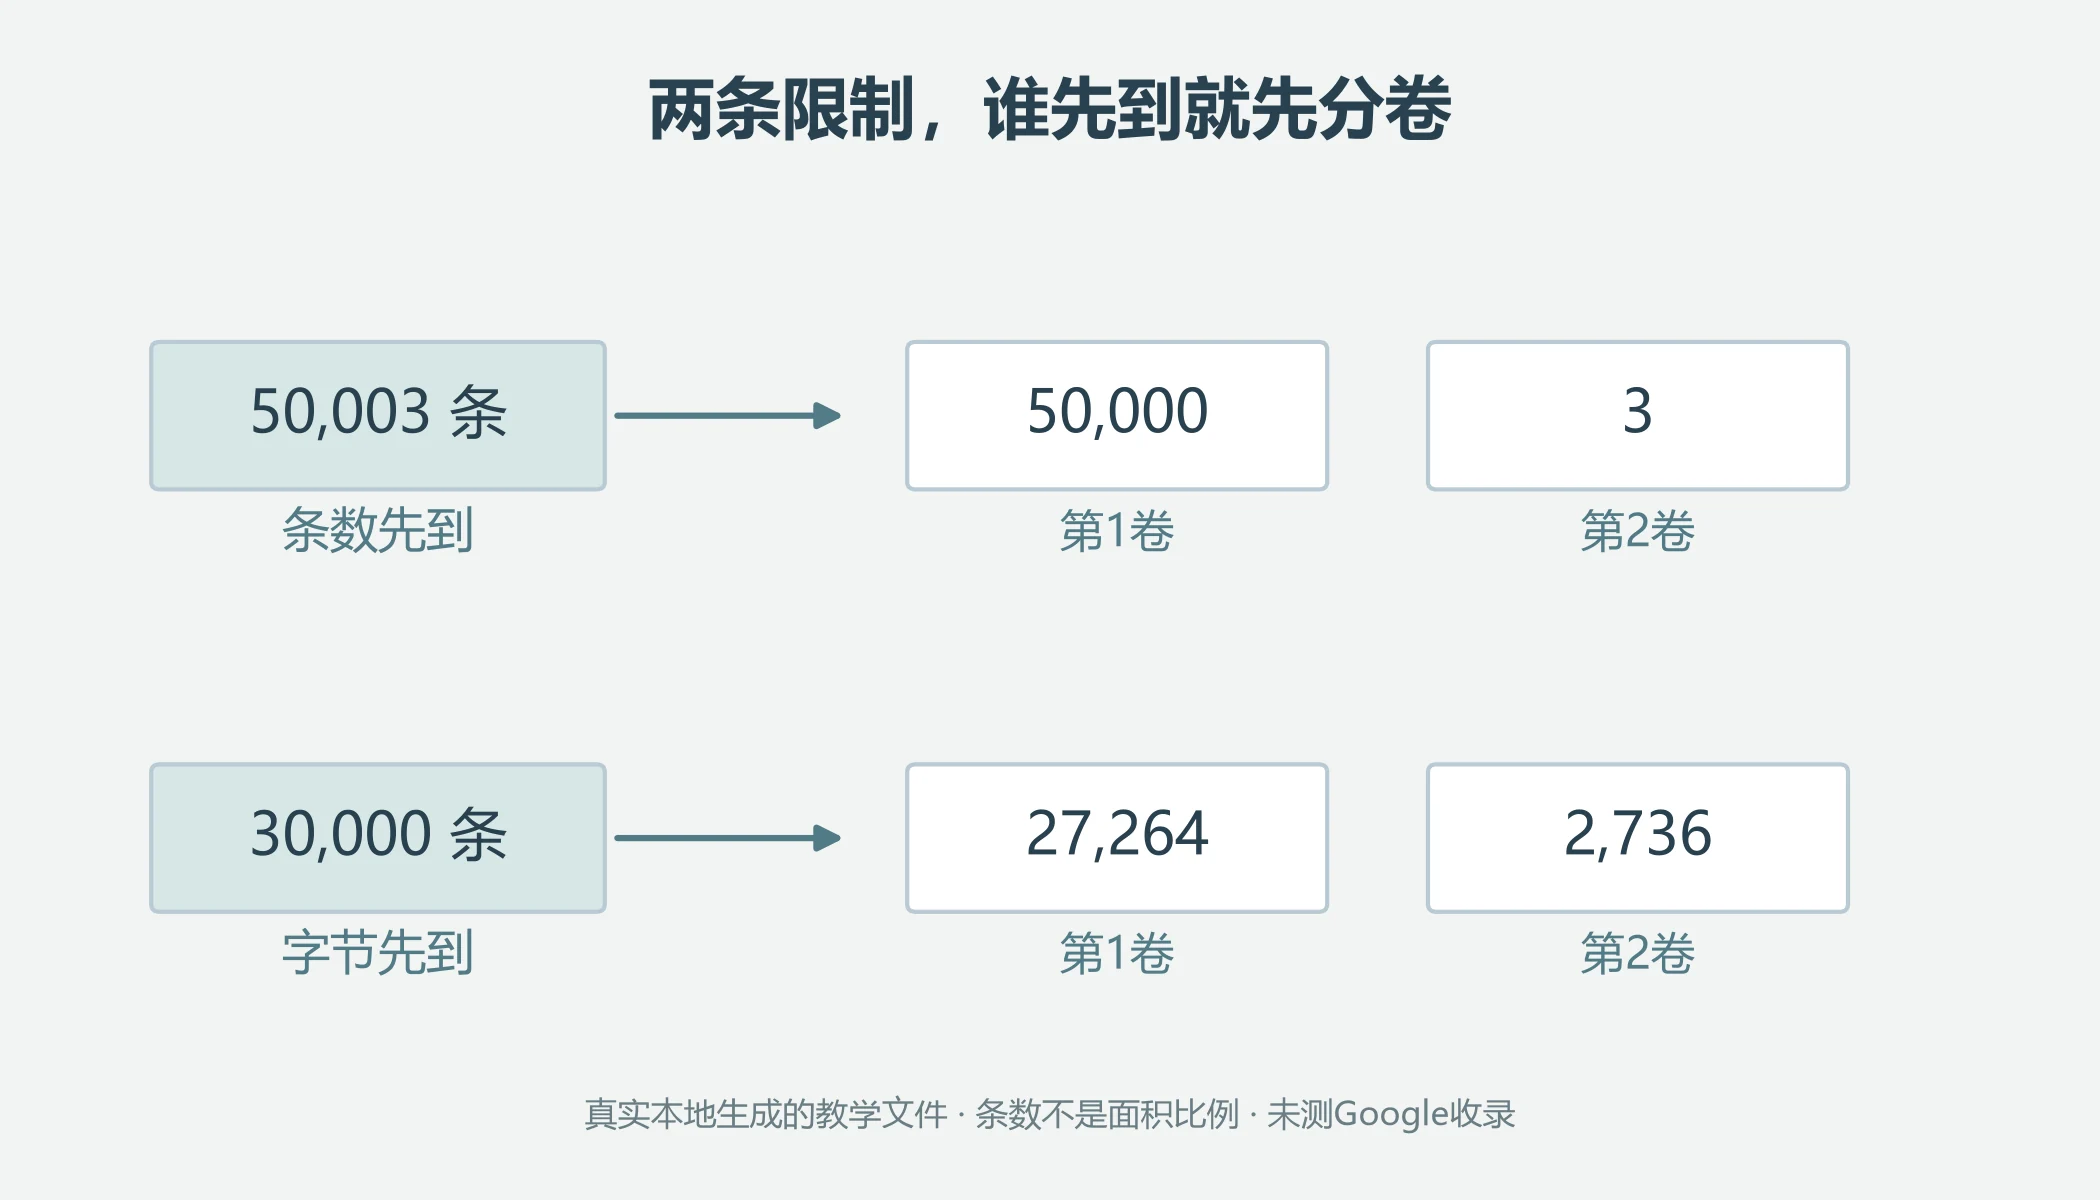
| 教学输入 | 第1卷 | 第2卷 | 为什么拆 |
|---|---|---|---|
| 50,003个短URL,每条最长36字符 | 50,000条,2,950,110字节 | 3条,287字节 | 先达到条数限制 |
| 30,000个长URL,每条1900字符 | 27,264条,52,428,782字节 | 2736条,5,261,438字节 | 先达到文件大小限制 |
第二批的第一卷还没到五万条,就已经接近52,428,800字节。再加入一个完整条目会超限,因此必须提前开新卷。这个长地址清单是专为验证边界构造的,不能把它解读成鼓励网站采用1900字符的URL。
第二批的第一卷gzip后只有156,374字节,仍必须按解压后的52,428,782字节验收。若把第二批三万条全部装在一份文件里,总量会超限;“压缩包很小”不能代替这个检查。
实际核对还包括:
- 每份XML能解析,根标签与命名空间正确,子地图非空且两项限制均满足。
- 把所有子地图的
loc解析出来合并,与原输入逐项比对:两批均无遗漏、无新增、无重复。 - 索引里的子文件列表与实际生成文件一致,没有少列一卷或引用不存在的编号。
- 另用一个含
&的URL检查实体转义,解析后取回的地址与输入一致。
这些文件也通过临时本地HTTP逐份取回并解析。它只能证明本地生成和读取结果,不代表正式网站的路径、CDN或访问控制已经验收,更不代表Google已经读取或索引。
实际项目不需要把每一卷都塞到离上限只剩几个字节。可设置更低的工作上限,为扩展字段或维护留出余地;这属于运行安排,没有“拆得越小排名越好”的结论。
上线先放子文件,再切索引并复核集合
发布顺序,避免索引先指向不存在的文件
保留本次导出的地址清单、新文件和原来可用的地图。先上传全部新子地图,确认公开地址确实返回XML,再切换或更新索引。如果新索引引用了 001 和 002,就分别打开这两个公开地址。两个文件都能正确读取后,再让索引对外生效。
自动生成器或发布系统若支持,可以用新一批文件名或临时目录完成检查,最后切换入口;同时核对索引与子地图的目录约束。不要直接删除旧文件后才发现新文件路径错误。旧地图保留多久,应结合现有引用、缓存与维护方式安排,不能只因编号变了就全删。
拆分前后,要比较地址,不只比较总数
总数一样也可能出错。例如原清单里少了一个重要产品页,同时多放一个参数版本,总数没有变化,内容却变了。
检查记录应包括:输入去重URL数、每卷条数和未压缩字节、输出合并后的去重数,以及“原输入减输出”“输出减原输入”和跨卷重复列表。如果拆分本身不承担筛选任务,这些差集应为空,重复也应为零。有计划排除的地址,应另列依据,不能隐藏在拆分结果里。
有lastmod或图片、视频等扩展时,再按同一URL对照关键字段,避免网址没丢、资料却丢了。普通集合相等只能证明地址关系相同,不能证明所有扩展字段都保住了。
最后检查公开文件,再提交实际入口
未登录请求索引及每一份子地图,核对初始响应、最终内容、XML解析、实际条数与字节。返回200却是一页登录或安全验证HTML,不算通过;只在本机文件夹解析成功,也不等于公开服务已经正确。
文件就绪后,在正确GSC资源的“站点地图”中提交实际索引地址,并核对后续读取记录。若入口变化,还要更新站内相应地图声明和维护记录。站点地图报告说明可用于区分无法取得文件、解析错误及地图内URL问题。
提交地图后,还要查看GSC的读取状态;提交本身不代表其中每篇文章已收录。文件链正常后,某个重要URL仍异常,就转到抓取与索引排查,核页面响应、指令、规范版本和内容;不要把所有未收录都归因于分卷。
若地图拆分后仍有重要页面未收录,可以回到谷歌 SEO 完整优化流程,按页面的访问、内容和入口继续查。需要补其他主题时,可从谷歌 SEO 学习路径找相应教程。
常见问题
插件只放1000条就开下一卷,是不是浪费了额度?
不一定。50,000是上限,不是每卷必须达到的目标。确认生成器、文件大小、更新和读取正常即可,不必为了凑满把现有自动分卷改成手工方案。
正好五万条,还需要再多建一个空子地图吗?
不需要。只要实际未压缩大小也符合限制,这一卷可以成立。没有剩余条目,就不应为下一编号输出空卷。
从子地图里删掉URL,就能让它退出Google吗?
不能。移出地图不等于移出索引。真实删除、保留但不索引和重复版本合并,需要分别处理页面状态、索引指令或规范信号;不能用分卷文件代替这些决定。