用 Python 可以把 Search Console 返回的查询与网页组合导出成 CSV。用有资源权限的账号完成只读 OAuth 授权,再联合请求 query 和 page,逐批写入文件。脚本只有在本次请求都成功后才生成正式 CSV。文件写完,表示这次请求成功,仍可能有 Google 未返回的查询。
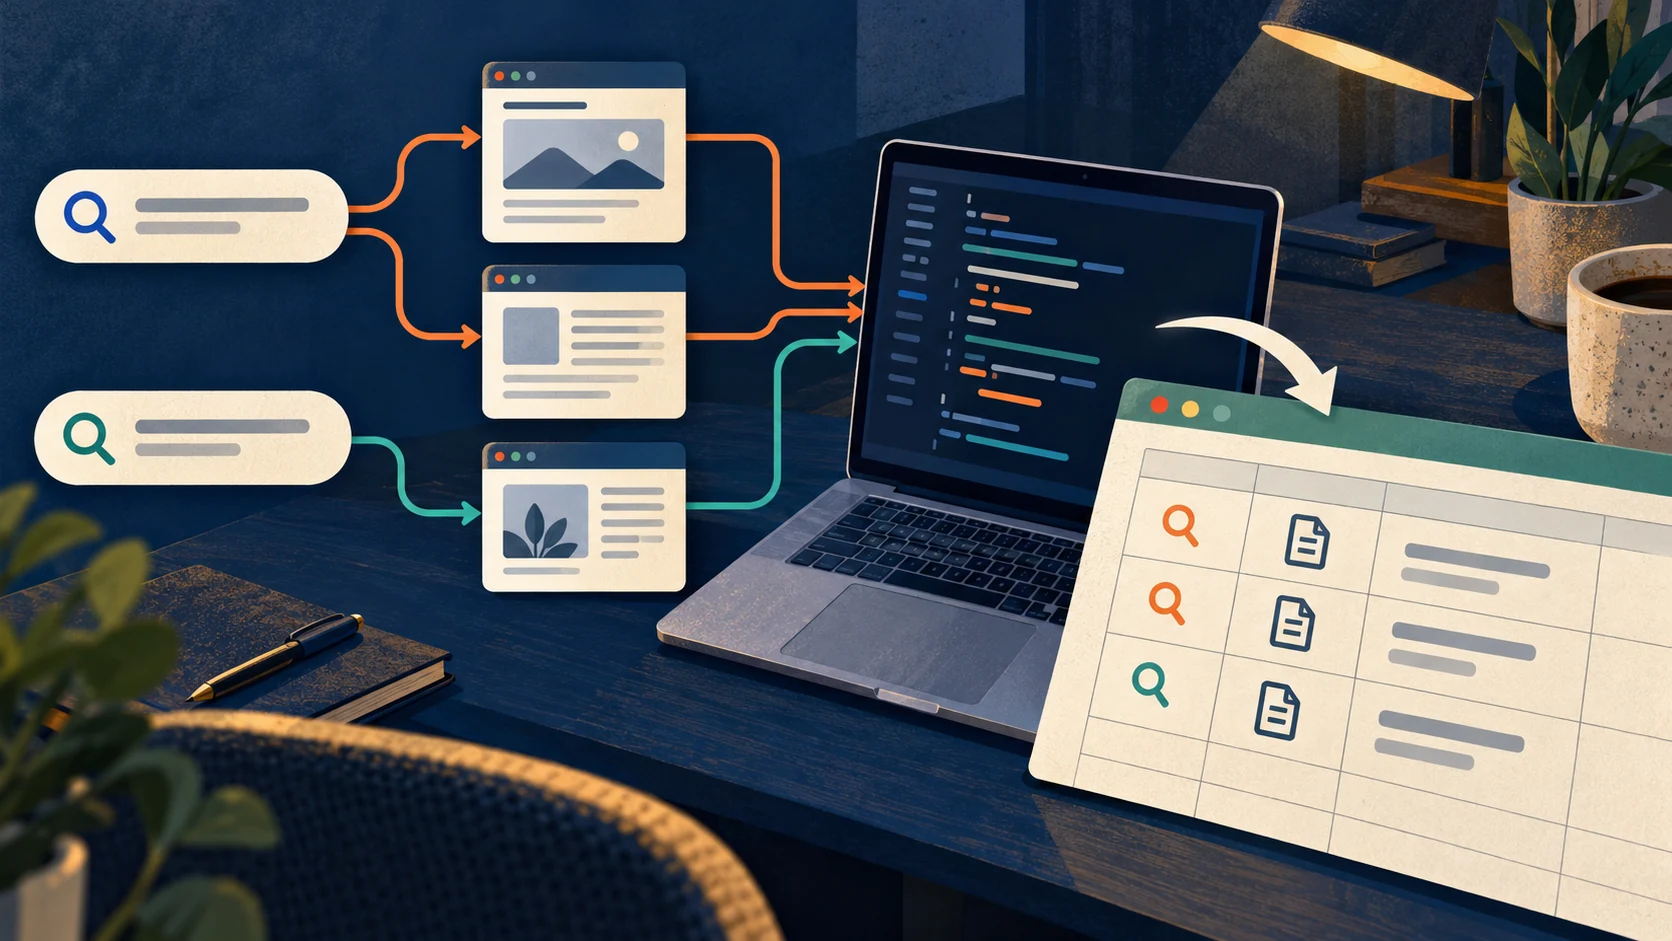
每周分别下载查询表和网页表,还是对不上「哪个词带来了哪张网页的点击」。两张表分别汇总,行号相同也配不成一组。本文导出的,是同一次请求中的查询与网页组合。只做一次少量分析时,也可以先用Search Console导出方式选择,判断是否值得维护脚本。
临时分析一周的数据,可以直接用本文的起止日期参数。定期保存明细时,建议按太平洋时间逐天运行,让开始和结束日期相同,为每天保存一份 CSV。脚本当前取的是网页搜索。图片等其他搜索类型要用各自的 type 分开请求。Google 的取数说明列出每个资源、每天、每种搜索类型最多 50,000 行。达到上限要在归档中标记。低于上限也可能有未返回的记录,不能补成零。
先看清楚,你准备导出的一行是什么
请求维度设为["query", "page"]后,每一行代表一个查询与一个网页的组合。一个查询对应两张网页,可能出现两行;一张网页对应多个查询,也可能出现多行。这不是用户级访问日志。
比如“工业台灯”同时带出产品列表和选购指南,不能把查询表第一行与网页表第一行直接配成一对。联合请求保留了组合关系,才能分析这些查询对应的网页。
API返回的keys按你请求的维度顺序排列。这里第一个值是查询,第二个是网页;如果以后改了维度顺序,写CSV的逻辑也要一起改。本文保持两项维度不变,先完成一份容易核对的文件。
运行前,准备账号、资源和本地环境
先确认当前Google账号能在Search Console打开目标资源。然后记下资源标识:域资源采用sc-domain:example.com,网址前缀资源采用对应的完整地址,例如https://www.example.com/。主机、协议和末尾路径要与实际资源一致,不要凭印象缩写。
接着在Google Cloud控制台完成以下准备:
- 选择自己的项目,启用Search Console API。
- 配置OAuth应用信息与所需受众;应用处于外部测试状态时,将实际登录账号加入测试用户。
- 创建类型为“桌面应用”的OAuth客户端,下载JSON,保存在本地工作文件夹,命名为
credentials.json。 - 使用后面的脚本请求
webmasters.readonly范围。它负责读取数据,不需要为了导出报告索取写入权限。
Cloud项目存在,不代表账号自动拥有某个网站的数据。应用授权与Search Console资源权限是两个条件:前者允许这段程序代表你请求,后者决定你能读取哪一份资源。相关要求见Search Console授权说明与Google桌面应用OAuth指南。
本例在个人电脑上打开浏览器完成授权,使用本地回调与PKCE,不采用已停止支持的手工复制授权码方式。credentials.json和稍后产生的gsc-token.json都留在本地,不要放到网站公开目录或文章附件里。
在该文件夹打开终端,使用Python 3安装依赖:
python -m pip install google-api-python-client google-auth-oauthlib
如果终端提示找不到python,先完成Python安装,并确认当前终端使用的解释器;不要把这个错误当成GSC权限问题。
完整脚本:分页写入,成功后才生成正式CSV
将下面代码保存为与credentials.json同目录的gsc_export.py。第一部分负责只读授权,第二部分负责取数和写文件;终端参数决定资源、日期与输出文件。
import csv
import os
import sys
import tempfile
from datetime import date
from pathlib import Path


def connect():
    from google.auth.transport.requests import Request
    from google.oauth2.credentials import Credentials
    from google_auth_oauthlib.flow import InstalledAppFlow
    from googleapiclient.discovery import build

    scopes = ["https://www.googleapis.com/auth/webmasters.readonly"]
    token = Path("gsc-token.json")
    creds = Credentials.from_authorized_user_file(str(token), scopes) if token.exists() else None
    if not creds or not creds.valid:
        if creds and creds.expired and creds.refresh_token:
            creds.refresh(Request())
        else:
            flow = InstalledAppFlow.from_client_secrets_file(
                "credentials.json", scopes, autogenerate_code_verifier=True
            )
            creds = flow.run_local_server(host="127.0.0.1", port=0)
        token.write_text(creds.to_json(), encoding="utf-8")
    return build("searchconsole", "v1", credentials=creds)


def excel_text(value):
    return "'" + value if value.lstrip().startswith(("=", "+", "-", "@")) else value


def export_csv(service, site, start, end, output, batch=25000):
    if date.fromisoformat(start) > date.fromisoformat(end):
        raise ValueError("开始日期不能晚于结束日期")
    if not 1 <= batch <= 25000:
        raise ValueError("batch必须在1到25000之间")
    target = Path(output)
    target.parent.mkdir(parents=True, exist_ok=True)
    fd, temporary = tempfile.mkstemp(prefix=target.stem + "-", suffix=".part", dir=target.parent)
    total, offset = 0, 0
    print(f"资源={site}; 日期={start}..{end}; type=web; dimensions=query,page; dataState=final")
    try:
        with os.fdopen(fd, "w", encoding="utf-8-sig", newline="") as stream:
            writer = csv.writer(stream)
            writer.writerow(["query", "page", "clicks", "impressions", "ctr", "position"])
            while True:
                body = {
                    "startDate": start, "endDate": end, "type": "web",
                    "dimensions": ["query", "page"], "dataState": "final",
                    "rowLimit": batch, "startRow": offset,
                }
                result = service.searchanalytics().query(siteUrl=site, body=body).execute(num_retries=3)
                rows = result.get("rows", [])
                for row in rows:
                    query, page = row["keys"]
                    writer.writerow([excel_text(query), excel_text(page), row["clicks"],
                                     row["impressions"], row["ctr"], row["position"]])
                total += len(rows)
                print(f"偏移={offset}; 本批={len(rows)}; 累计={total}")
                if len(rows) < batch:
                    break
                offset += len(rows)
        os.replace(temporary, target)
    except Exception:
        print(f"导出未完成;临时数据保留在 {temporary};正式文件未替换", file=sys.stderr)
        raise
    print(f"完成:{target},共{total}行;分页完成不等于Google全部搜索记录")
    return total


if __name__ == "__main__":
    if len(sys.argv) != 5:
        raise SystemExit("用法:python gsc_export.py 资源 开始日期 结束日期 输出.csv")
    export_csv(connect(), *sys.argv[1:])
rowLimit控制每批最多返回多少行,startRow表示从哪一行继续。上一批满额时继续请求;成功返回短批次或空行时结束。字段定义与日期口径可核对Search Analytics query文档。
这里没有把所有返回结果先塞进内存,而是逐批写入.part。当某一批报错,已有正式CSV不被替换;只有循环正常结束,临时文件才改成指定输出文件。这能避免同事看到文件存在,就误认为本周数据已经完整取完。
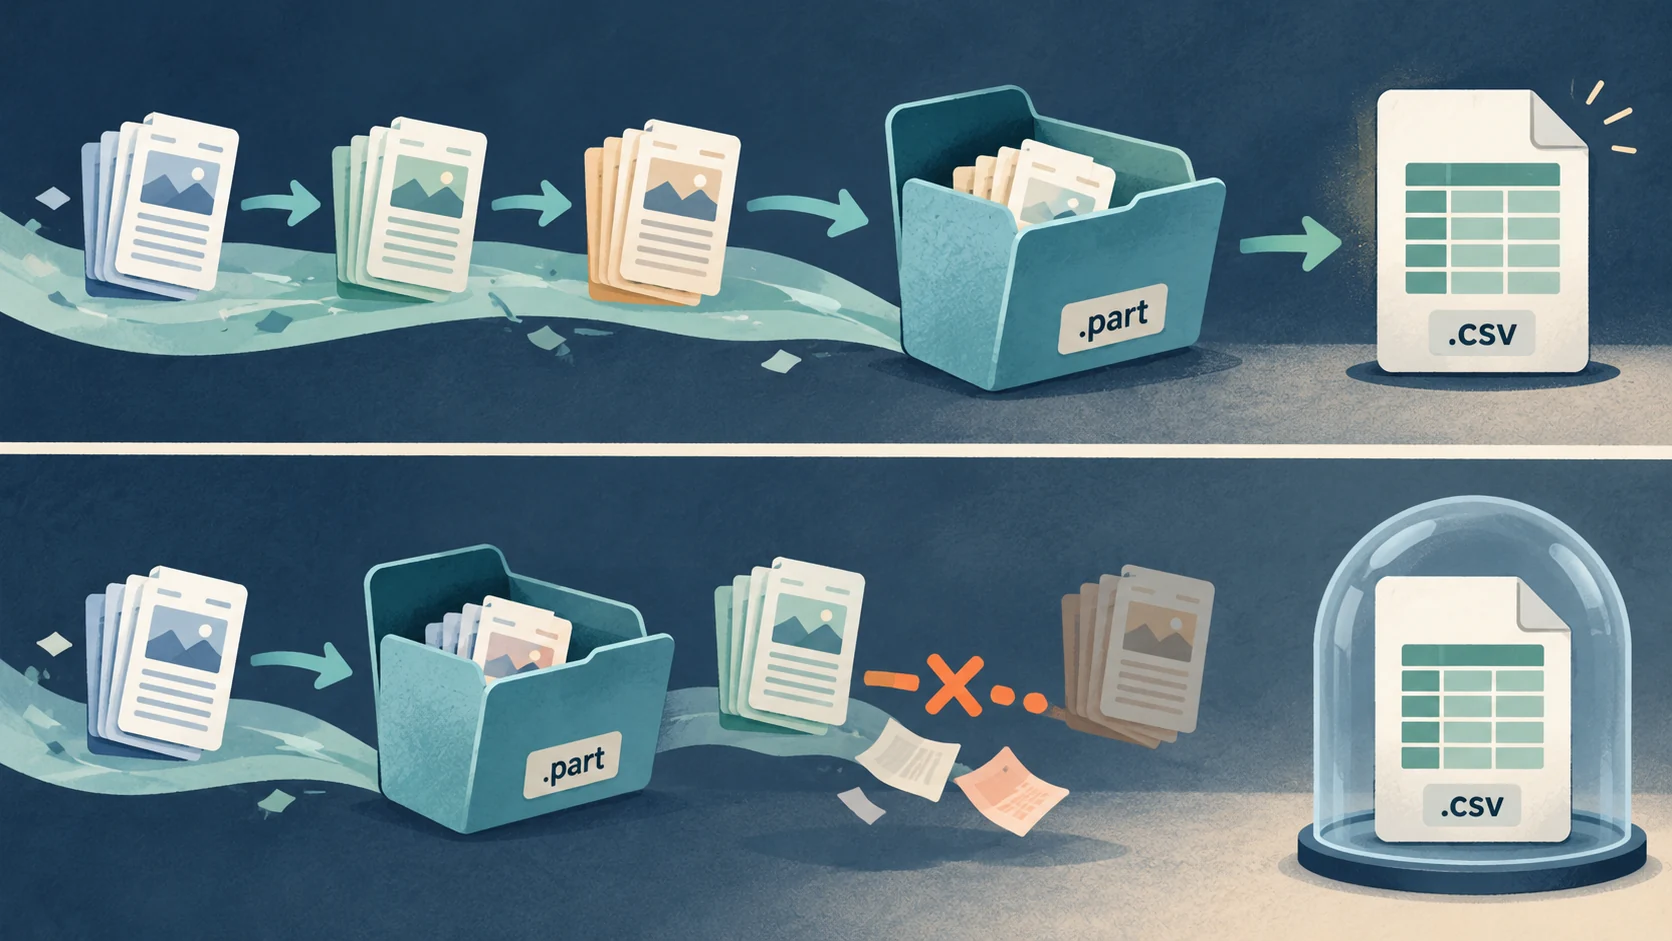
客户端对可重试的请求错误最多额外重试三次。仍失败时,终端会保留原始错误。首次授权所用的InstalledAppFlow本地回调由Google维护的库处理,不需要自己搭一台公网服务器。
执行命令,观察授权与文件结果
仍在同一文件夹运行下面的命令。域名与日期是教学值,需要换成自己的真实资源和所需范围:
python gsc_export.py "sc-domain:example.com" 2026-10-01 2026-10-07 "gsc_2026-10-01_07.csv"
首次运行会打开Google授权页面。确认账号和所请求的只读范围,完成授权后回到终端;本地会产生gsc-token.json。后续有效凭据可被复用或刷新,被撤销、过期或受应用测试状态限制时,需要按实际错误重新处理,不保证永远免登录。
Search Console请求日期采用太平洋时间口径,开始与结束日期都包括在内。这里取10月1日至7日,表示该口径下的这七天,不是把北京时间零点直接套进去。脚本使用dataState="final";近期尚未完整的数据与更早完整区间不要混成同一种月报结论。
为说明分页,下面用每批2行、第一批返回2行、第二批返回1行的教学响应展示输出。它不是本站Google账户的在线数据,也不需要你为跟随教程构造这些数据:
偏移=0; 本批=2; 累计=2
偏移=2; 本批=1; 累计=3
完成:示例文件.csv,共3行;分页完成不等于Google全部搜索记录
正常使用保留脚本默认批量即可,不必为了跟这个演示一致改成2。若第二批抛出错误,程序保留.part并退出,原有正式文件保持不变;请求成功却没有返回记录时,则生成只有表头的CSV。这三种结果分别是完成、失败和当前范围无返回记录,不能都写成“零点击”。
重跑时会从头请求,不会自动接着上次的.part继续。确认成功后,旧临时文件可以按自己的数据保存规则处理。文件名写上起止日期。旁边保存运行命令和终端输出,方便复查用的是哪个资源、哪些日期,以及这次有没有跑完。
打开CSV后,先核一行,再开始分析
CSV列顺序固定为:
query,page,clicks,impressions,ctr,position下面是一行自拟教学数据,不是实际网站表现:
| 查询 | 网页 | 点击 | 展示 | CTR原值 | 平均位置 |
|---|---|---|---|---|---|
| 工业台灯 | https://example.com/lamps/ | 8 | 200 | 0.04 | 11.5 |
这行表示:在本次请求范围内,该查询与该网页的组合有8次点击、200次展示,CTR为4%,平均位置为11.5。0.04是比例;在Excel设为百分比格式即可,不要先乘100后再设百分比。平均位置也不是现在打开Google就必然看到的第11或12名。
选一行回到相同Search Console资源,固定相同日期与搜索类型,按该查询和网页组合核对。默认脚本没有添加国家和设备过滤;如果界面还保留美国手机等条件,先清除无关筛选,再比较。核对口径的方法可回到Search Console效果报告读法。 还要处理验证、收录或统计差异时,可从GSC教程专题按当前问题分流。
文件采用带BOM的UTF-8,方便Excel识别中文。为避免搜索词被表格软件当公式执行,excel_text会给以=、+、-或@等字符开头的文本加一个单引号。需要把该类词重新用于API精确匹配时,应回到原始查询核对,别把这个显示保护前缀也传过去。
如果正式CSV在Excel里已经打开,Windows可能阻止脚本替换文件。先关闭文件再重跑;不要因为没出现新文件,就把旧日期的数据当成本次结果。
请求失败时,改哪一处
先看终端原始错误,不急着删令牌或反复点运行。脚本没有把异常转换成空数据,错误本身就是定位下一步的资料。
| 现象 | 先核什么 | 处理后的确认 |
|---|---|---|
| 找不到credentials.json | 终端所在文件夹、实际文件名及是否下载了桌面客户端JSON | 程序能进入正确客户端的授权流程 |
| 授权账号不在测试用户中,或被组织限制 | 应用受众、测试用户与组织策略 | 用允许的真实账号完成授权,不绕过组织限制 |
| 401或刷新凭据失败 | 令牌是否撤销、过期,是否属于当前应用 | 确认原因后重新授权,再重跑本次任务 |
| 403 | 错误正文里的原因、API是否启用、当前账号的资源权限、资源标识,以及配额原因 | 对应原因解除后,数据请求成功;只在Cloud有权限还不够 |
| 429或临时服务错误 | 返回原因、请求频率、服务状态 | 重试达到上限后仍失败,就保留记录,调整调用安排再试 |
| 成功但没有行 | 日期是否有已完成数据、资源是否正确、筛选范围是什么 | 将它记为该请求无返回,不补造查询或指标 |
不要把所有403都归为网站没权限,也不要用“等五分钟肯定恢复”处理所有429。范围、应用身份和服务限制不同,需要读实际返回原因。若不清楚自己到底需要GSC、SERP还是GA4数据,先用SEO数据API的分工与请求示例确定需要哪一类数据,再继续调试。
导出了文件,仍要保留哪些限制
每次归档保留资源、日期、搜索类型、维度和返回行数。分析查询与网页的组合时用这份 CSV。要做网站总体月报,另按同一范围请求资源汇总,去掉查询和网页维度,再保留两套数据各自的用途。Google 的导出说明
所以,脚本里的“完成”只表示这组请求和文件写入正常完成。明细总和仍可能与图表不同,这些组合数据也不能对应某个客户的询盘。
文件核对无误后,下一步按SEO页面诊断顺序查看查询实际落在哪页、页面缺什么答案。分析后要安排改动,再对照谷歌SEO完整流程排优先级;对报告指标还不熟悉,可从谷歌SEO学习路径补对应基础。
常见问题
只有API Key,能导出自己网站的数据吗?
读取Search Console私有数据需要OAuth及目标资源权限。API Key识别项目,不能替代有权限用户的授权;本文脚本走的是桌面只读OAuth流程。
这份脚本可以直接丢服务器,每周自动跑吗?
本例先解决本机交互授权与手动运行。服务器无人值守还涉及身份方案、凭据保存、运行环境、失败通知和记录,不是把文件上传就自动具备。先在本机完成一次正确导出,再按实际维护能力安排部署。
为什么有网页展示,查询组合却没有全部出现?
网页汇总与查询、网页组合不是同一份明细,隐私和内部取数限制也会影响返回。先确认范围一致,再保留已返回的数据,并注明它不是完整查询记录;不要把未返回的词补成0,更不能按比例编造查询点击。