把品牌资料、编辑规范和产品说明反复交给模型,是批量做内容时常见的一笔重复开销。Fable 5.1降低了缓存读取价格,对这类工作有直接影响,但“缓存读取降价75%”不能直接换成“十篇文章便宜75%”。
Anthropic在2026年9月发布Fable 5.1,缓存读取从Fable 5的每百万token 1美元降至0.25美元,普通输入和输出价格保持不变。整批省多少,取决于真正命中的共享输入占比,以及输出和重写消耗。 官方发布说明
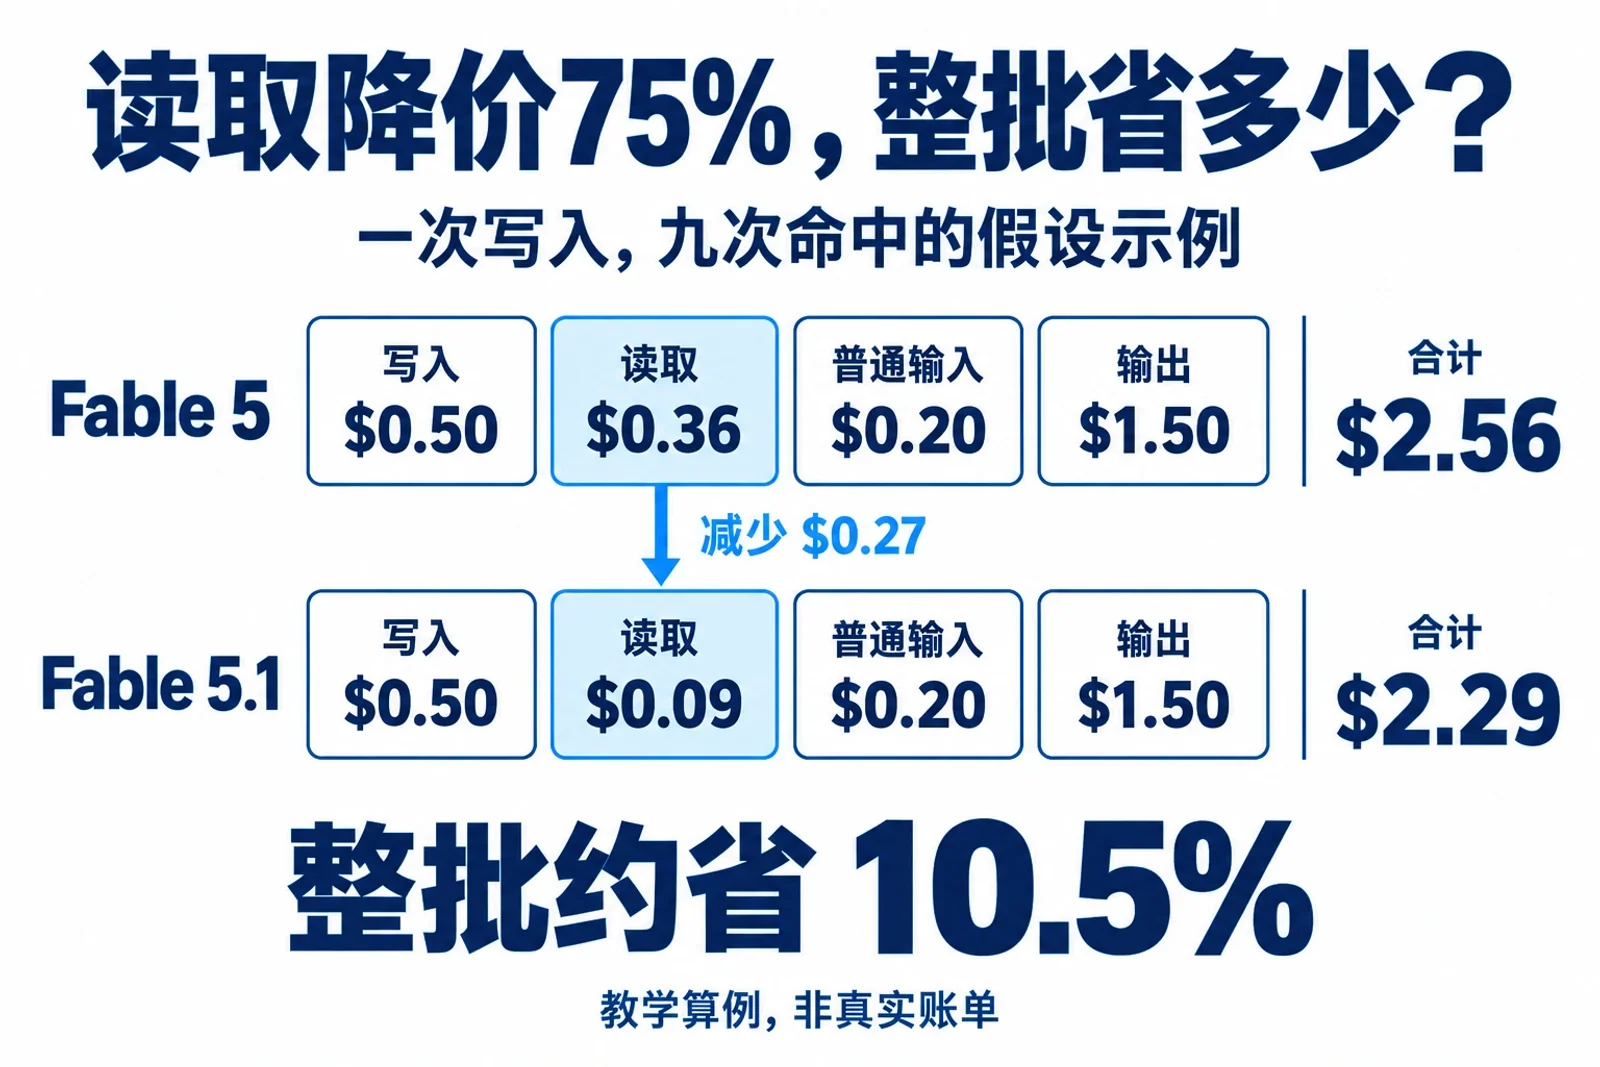
下面按一个十篇内容任务算账:旧模型已使用缓存时,示例费用为2.56美元;换成Fable 5.1后为2.29美元,省约10.5%。如果十次都没能复用缓存,结果还可能更贵。所有数量都是演示假设,不是我们的实测账单。
先看四种费用:读取便宜,首次写入仍要付费
截至2026年10月11日复核,官方价格表中Fable 5.1的标准token价格如下。MTok指一百万token,不能直接当成一百万个汉字或单词;中文内容的实际数量应看请求计量。
| 计费部分 | Fable 5.1:美元/百万token | 在内容任务中的例子 |
|---|---|---|
| 普通输入 | 10 | 本篇题目、当前资料和新指令 |
| 5分钟缓存写入 | 12.50 | 首次把共享品牌资料写入缓存 |
| 1小时缓存写入 | 20 | 为较长间隔保留同一共享资料 |
| 缓存读取 | 0.25 | 后续请求命中同一资料前缀 |
| 输出 | 50 | 模型生成的文本等计费输出 |
这组数字适用于本文设定的直连Claude API、标准全球推理计费。Batch折扣、其他云平台、指定推理地区、工具调用及其他附加费用需分别核对;本文不把它们混进普通请求算例。官方价格表
首次写入5分钟缓存比同样数量的普通输入贵25%。只有后续复用,才有机会收回这部分费用。因此,“为提示词开启缓存”与“账单里出现有效缓存命中”是两回事。Pro、Max等订阅的费用和额度也不能拿这张API价格表直接重算。
把共享资料放前面,每篇变化的内容放后面
提示缓存按可复用的提示前缀工作。两段文字意思相同但表达不同,不能当作同一份缓存;在前面加入每次变化的日期,也可能让后面的长篇资料失去复用机会。
内容生产中,可以把已经核实的品牌事实、固定编辑规范、产品术语和适用于本批的内链清单放在稳定部分。每篇题目、搜索意图、当前研究来源和段落要求放在后面的变化部分。不同客户的资料不能为了省费用混用同一份事实。
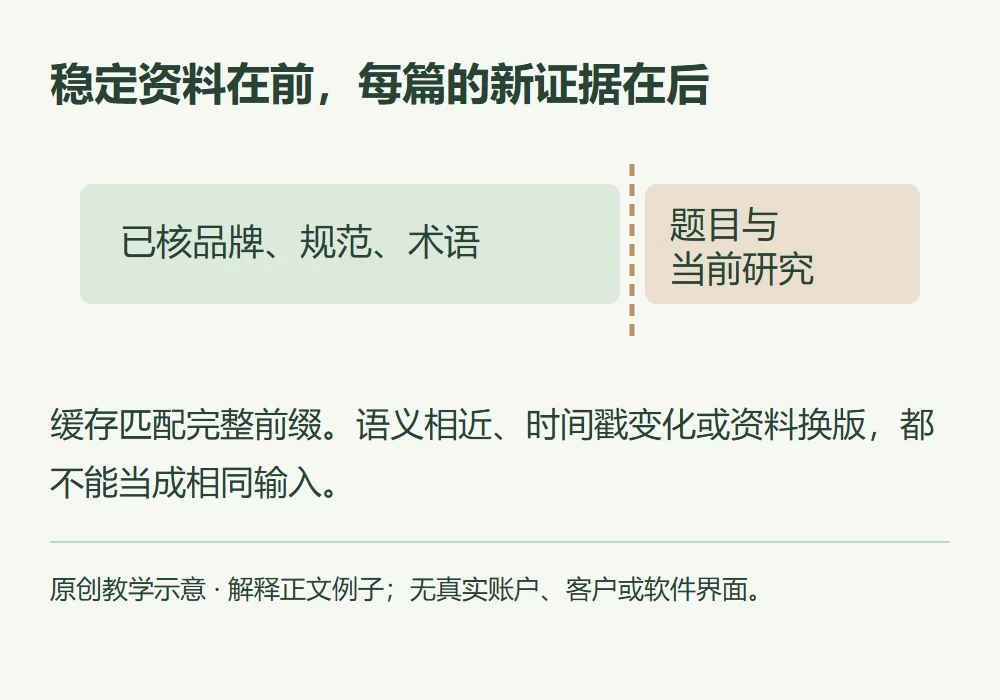
例如,十篇都是同一家企业的内容,品牌说明和写作规则一致,而产品主题各不相同。请求的逻辑顺序可以是:
- 固定规则:哪些事实已确认,哪些内容不能自行推测,文章如何交付。
- 固定资料:品牌、术语、适用于本批的产品范围与链接。
- 在共享部分末尾设置缓存控制。
- 本篇任务:题目、读者问题、具体来源与需要完成的分析。
在Messages API中,共享文本块可以带cache_control: {"type": "ephemeral"},默认保留时间为5分钟;需要1小时时使用相应ttl设置。模型ID为claude-fable-5-1。具体请求结构仍按你使用的SDK和API文档配置,不是在Claude聊天框里输入一句“请缓存”就完成。
当前文档列出的Fable 5.1最低可缓存长度为512 token。短于门槛的提示不会因为加了标记就产生预期命中。也不值得为了越过门槛塞入无关文字;先看这批任务本来是否有足够长、确实共同需要的输入。提示缓存文档
十篇文章的账单:2.29美元是怎样算出来的
假设同一批共有十次请求,每次使用40,000 token的固定资料,另有2,000 token的本篇输入,并产生3,000个计费输出token。这里是为了看清价格关系,并不建议给每篇文章机械设定同样长度。
再假设第一次写入5分钟缓存,后面九次都成功读取,其他计费条件不变:
| 费用项 | 数量与算式 | 金额 |
|---|---|---|
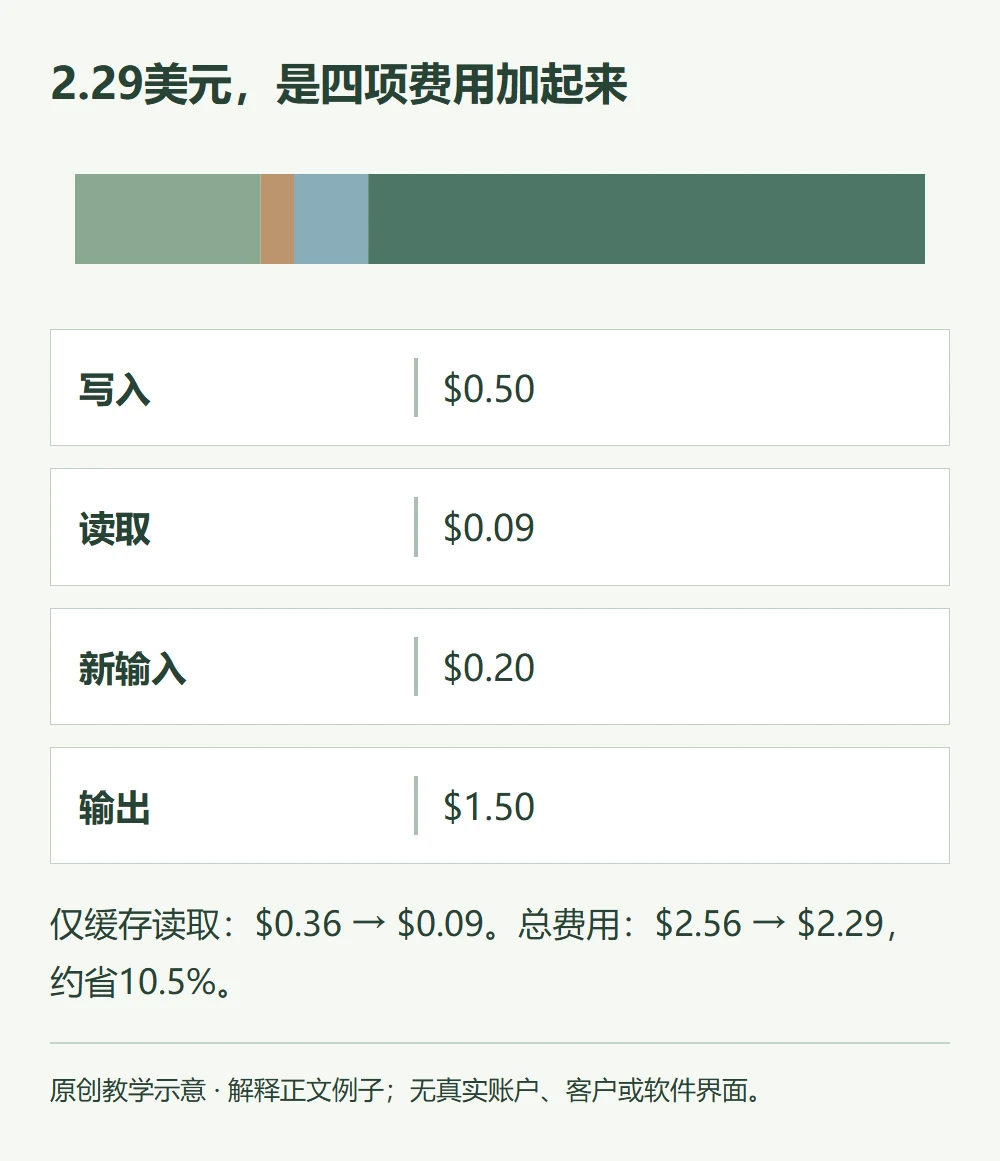
| 首次共享资料写入 | 40,000 ÷ 1,000,000 × 12.50 | $0.50 |
| 后续九次读取 | 40,000 × 9 ÷ 1,000,000 × 0.25 | $0.09 |
| 十篇各自输入 | 2,000 × 10 ÷ 1,000,000 × 10 | $0.20 |
| 十篇输出 | 3,000 × 10 ÷ 1,000,000 × 50 | $1.50 |
| 合计 | $0.50 + $0.09 + $0.20 + $1.50 | $2.29 |
输出占了这份账单的大半,所以只降低缓存读取单价,不会让总费用按同样比例下降。
若使用Fable 5且缓存表现完全相同,九次读取费用为360,000÷1,000,000×1=$0.36。其余部分不变,总计2.56美元。模型升级省下0.27美元,比例为0.27÷2.56≈10.5%。
如果之前根本没用缓存,十次共享资料都按普通输入计费,费用为(40,000 + 2,000) × 10 ÷ 1,000,000 × 10 + 1.50 = $5.70。从5.70降到2.29,节省约59.8%,但这同时包含了“开始使用缓存”的效果。把它全部归功于Fable 5.1降价,会高估模型升级本身的收益。
这里有两个不同的问题:你是在比较新旧模型,还是比较有无缓存?向团队汇报时,先写清比较对象,才能决定下一步该升级模型还是先修好请求结构。
看usage字段,就能知道优惠有没有真正发生
对API请求保留返回的usage,将下面四个字段分别计入,不要把input_tokens当成含缓存的全部输入:
cache_creation_input_tokens:本次写入缓存的输入数量。cache_read_input_tokens:本次从缓存读取的输入数量。input_tokens:未被缓存读取或写入覆盖的普通输入。output_tokens:本次计费输出数量。
在上面的简化示例里,第一次请求应能看到约40,000个写入、2,000个普通输入;后面的成功复用请求应看到约40,000个读取、2,000个普通输入。真实请求还会有消息结构等差异,因此以实际返回值算钱,不要求它恰好等于示例整数。
只有一种5分钟写入时,单次费用可以按下面的式子复算:
费用 = 写入数量×12.50/1000000 + 读取数量×0.25/1000000 + 普通输入数量×10/1000000 + 输出数量×50/1000000
若混用了5分钟与1小时缓存,应按返回的写入时长分类分别乘以价格,不能把所有写入都乘12.50。建议保存请求时间、模型ID、四类token数量、缓存时长及任务编号;无需把API密钥或客户原始文本放进成本表。
看到读取数量为零时,先看写入是否发生。如果每次都有大额写入,问题更可能出在复用条件;如果读写都为零,先查长度门槛与缓存控制位置。两个现象对应的修改不同。
缓存没省钱时,按三个位置查
前缀变了:检查真正发出的请求
程序可能在最前面插入生成时间、随机任务ID,或者每篇都重排资料顺序。肉眼看主要内容相同,不代表发送给API的前缀一致。
选两次相邻请求,比较缓存边界之前的实际序列化内容,将每篇变化的信息移到边界之后。修改后重跑一组小样,观察第二次的cache_read_input_tokens是否出现预期数量。共享品牌事实真的更新了,就接受重新写入;省钱不能成为保留旧事实的理由。
并发太早:第一份缓存尚未可供复用
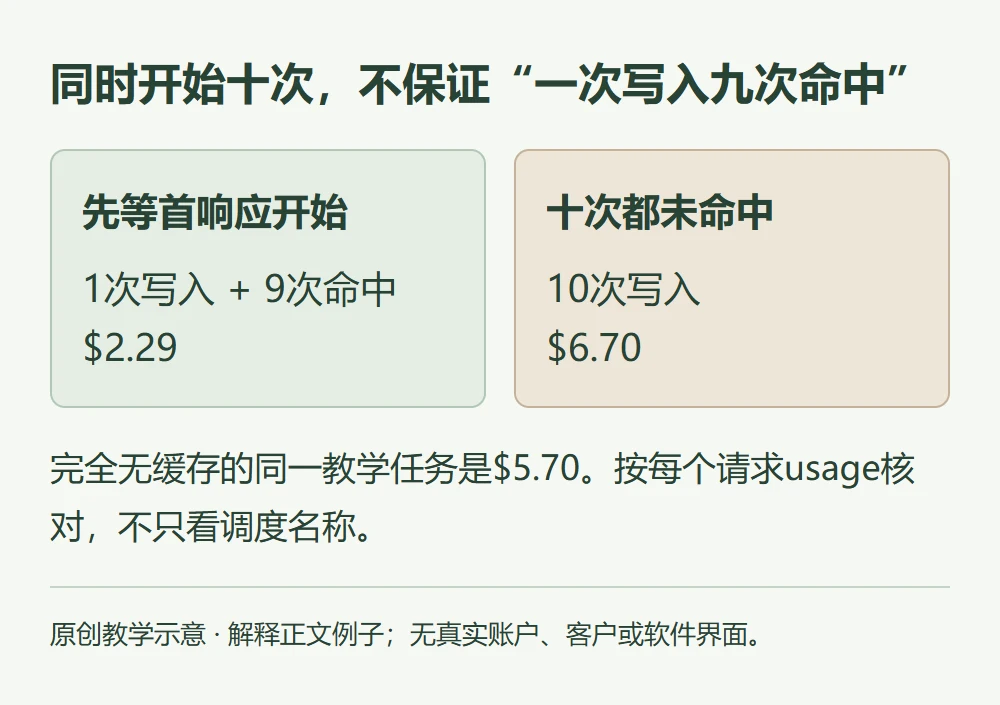
当前官方文档说明,缓存条目在首次响应开始后才可用于后续请求。如果一次把十个相同前缀请求同时启动,不能假定它们天然是一次写入加九次读取。
可以先让首个请求开始返回,再启动余下任务,并用各自的usage确认。如果十次都写入了40,000 token,本例的写入费用会变成5美元;加上普通输入0.20美元和输出1.50美元,合计6.70美元,比完全不缓存的5.70美元还高。这是一个需要检查调度的信号,不是降低文章字数就能解决的问题。
间隔超过有效期:比较延长缓存与重新写入
默认5分钟从请求开始计时,不是等整篇文章生成结束才开始。命中会刷新有效期;如果中间要等人工审稿,后续请求可能已经过期。
仍以本文假设计算:使用1小时缓存且只有首次写入时,费用为0.80 + 0.09 + 0.20 + 1.50 = $2.59,高于全部命中5分钟缓存的2.29美元。但如果5分钟方案中有一次读取变成重新写入,总费用就增加0.50 − 0.01 = $0.49,变为2.78美元。在这一个具体情形下,1小时方案更低。
因此,连续快速处理的任务可以先看5分钟方案;需要跨过人工审核间隔的任务再估算1小时方案。关键是实际间隔与重写次数,不需要为了“保持活跃”不断发送没有业务用途的请求。
把成本算到合格稿,而不只算到一次生成
费用下降以后,值得观察的是同样资料能否稳定产出可用内容。若十篇初稿花2.29美元,只有八篇达到发布要求,暂不考虑人工费用及返工时,每篇合格稿对应的API成本已经是2.29÷8≈0.286美元,而非按十篇分摊的0.229美元。后续修订请求还要继续累加。
实际记账时,可以把一个文章任务下的提纲、正文、事实修订和格式修复请求归在一起,再记录最终是否通过。若换模型后少了缓存费,却增加大量事实返工,应该先查看失误集中在哪一步。价格表只能解释token费用,不能证明内容质量更好。
测试可以从几篇既有高质量文章的任务要求开始,保留相同资料与验收规则,分别记录数字准确性、主题覆盖和需要修改的段落。关于怎样避免把“输出很长”当成质量,可以继续看AI助手评估与测试质量。
常见问题
缓存读取降价75%,为什么本文总费用只降约10.5%?
75%只作用于示例中的缓存读取费,0.36美元降到0.09美元。写入、普通输入和1.50美元的输出费用都没有跟着降低,因此总额只从2.56变成2.29美元。
每篇文章都不一样,还能复用缓存吗?
可以复用各篇确实共同需要、内容保持一致的前缀。本篇研究和题目放在后面变化;不要缓存整篇上一稿并期待它自动适应另一主题,也不要把语义近似当成字面一致。
我只有Claude Pro账户,会自动按这个价格扣费吗?
本文计算的是按token计费的API请求,不能直接套到Pro订阅。先确认使用的是订阅界面、直连API,还是其他平台代付接口;不同账单需要用各自计费规则核算。
十篇内容都能安排在五分钟内,就一定只写入一次吗?
不一定。缓存前缀、长度门槛、控制位置以及首次响应是否开始,都影响复用。最终以每次usage的读取和写入数量为准,而不是根据任务开始时间猜测。
为了省钱,把全部品牌资料都塞进固定前缀合适吗?
只保留本批任务真正需要的稳定资料。缓存能降低重复读取价格,但不会让无关资料变得有用。过期资料、冲突规格或不适用于当前客户的说明,仍会影响文章判断,应先整理资料再谈复用。