PDF可以被Google索引。准备让客户通过搜索找到一份公开文件时,先把内容和文字层做好,再核文件标题、版本、阅读体验与网页下载入口。文件名改成关键词,只完成了一小部分;漂亮封面也不能代替可读文字。
本文处理已经决定保留搜索机会的公开PDF。如果你正纠结PDF是否该指向网页、退出搜索或继续独立存在,先看PDF与网页的分工,再执行这里的制作与上线检查。 配套下载网页的标题、说明和入口,也要按页面SEO检查清单验收,不能只优化文件。
先判断PDF是不是合适的搜索落点
安装手册、规格记录、打印清单和需要离线留存的资料,可能适合PDF。需要筛选、选规格、随库存变化或直接询价的任务,通常还需要网页承担交互,不能把一份下载文件当成完整业务页面。
例如“产品拍摄准备清单”,读者可能希望打印后交给摄影师,PDF有实际用途;“选择哪一款并查看当前价格”,只给一份半年不更新的目录就可能让用户作错判断。
Google目前的可索引文件类型包含PDF。这只说明类型受支持,不表示每份PDF都值得收录或一定会参与某次查询。
下面用一份本地制作的《产品拍摄准备清单》作教学例,检查文字、Title与下载入口。它是演示文档,不是某个客户的真实项目资料,也没有相应搜索排名记录。
文字能选中,是第一步检查
打开文件,尝试选中一段正文并复制到纯文本编辑器,再搜索一个文件里的独特短句。检查型号、数字、中文和单位有没有丢失、乱码或顺序错乱。
PDF看起来有字,背后可能只是扫描图片。扫描件可以经过OCR产生文字层,但识别可能把字母与数字认错、漏掉脚注或打乱多栏阅读顺序,不能只看软件提示“识别完成”。
用同一句话比较两种文件
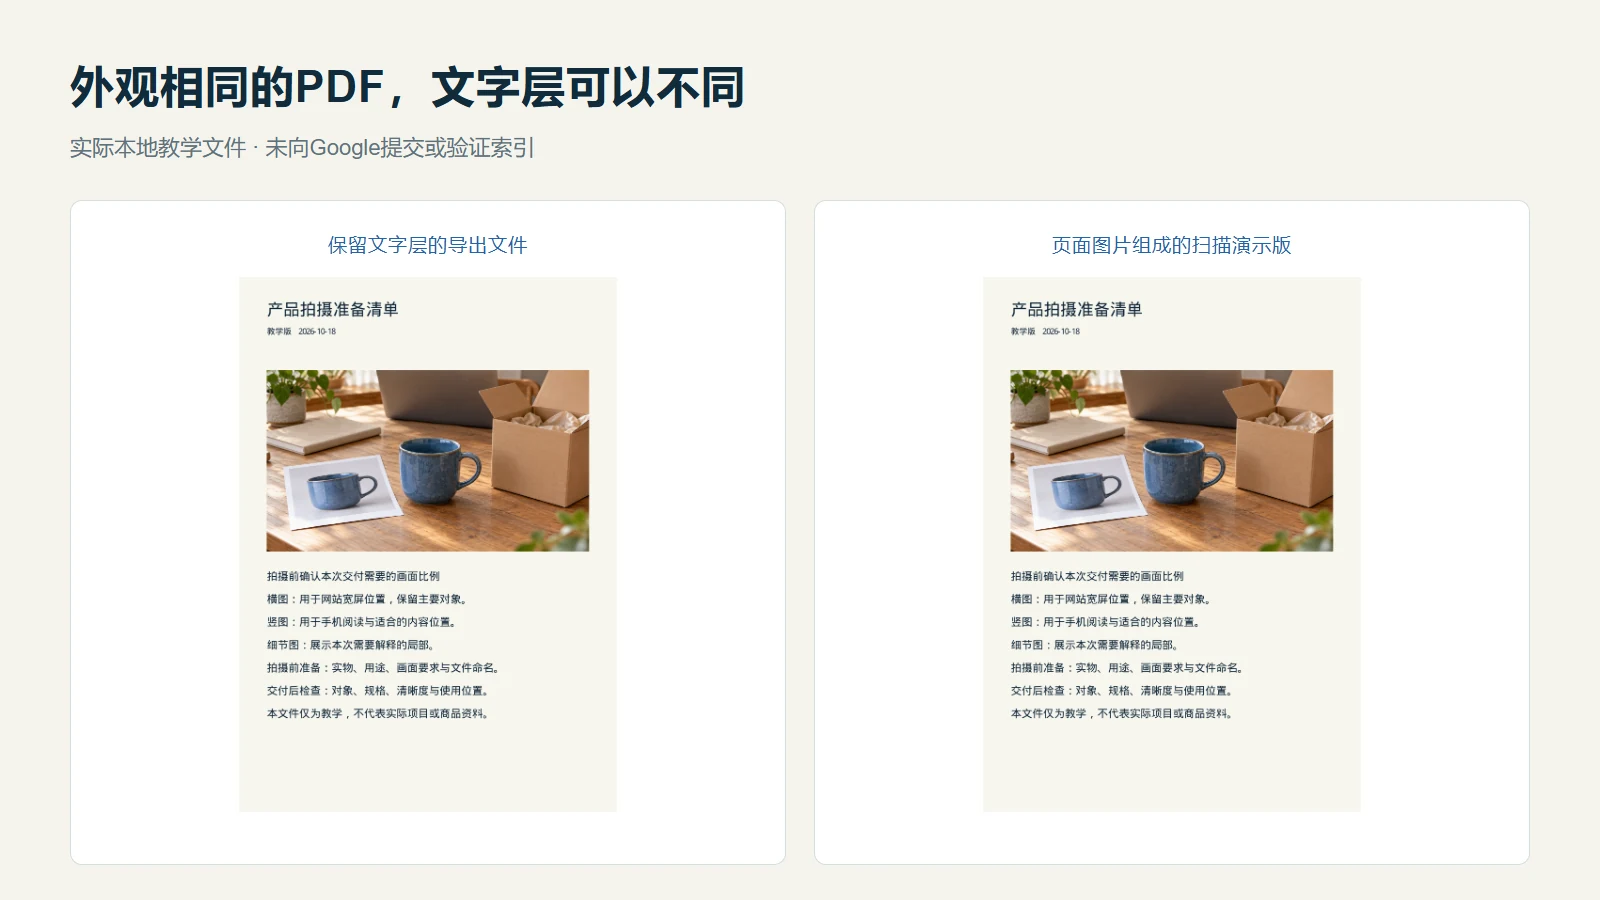
教学文档里有一句“拍摄前确认本次交付需要的画面比例”。把它分别放进只有页面图片的PDF和保留文字层的PDF:
| 检查 | 只有页面图片的版本 | 保留文字层的版本 |
|---|---|---|
| 肉眼看见这句话 | 可以 | 可以 |
| 直接复制成文字 | 没有原生文字可复制 | 可以取得文字 |
| 文件内搜索 | 取决于阅读器是否额外做OCR | 可用文字搜索定位 |
| 进一步处理 | 从原稿重新导出或OCR后校对 | 再核顺序与关键字段 |
Google在PDF搜索说明中解释过文字提取与OCR。这是2011年的一手技术说明,不能把当年的例子当成今天的排名数据,也不应因此放心交付模糊扫描件。自己能提供准确文字,就不要把识别正确与否交给后续系统猜。
如果发现错误,优先回到原始文档修正再导出;只有扫描原件时,OCR后逐项校对会影响判断的字段。需要保留原始扫描版,也可以另提供经过核对的可读版本,并标明两者关系。
文件标题、页内标题和文件名怎样配合
这里有三个对象,容易被混在一起:
- 文件名:例如
product-photo-preparation-checklist.pdf,出现在下载地址或保存文件时。 - 页内标题:读者打开文件后看见的主标题。
- Title元数据:保存在PDF属性中的文档标题,可能沿用旧模板或原始文档名称。
三个对象应表达同一份资料,但不要求每个字符完全相同。教学文档的文件名可以用简洁英文,Title和页内标题用清楚中文;关键是别让客户下载“产品拍摄准备清单”,属性却仍写“未命名文档1”。
先改源文档,再读导出后的PDF
以Windows版Word为例,可以沿下面这条路径修改。其他编辑器的菜单不同,但最后都要检查真正导出的PDF。
- 打开源文档,进入“文件 → 信息”,在属性中填写“标题”。本例填“产品拍摄准备清单|教学示例”;没看到字段时,展开“显示所有属性”。封面上的大标题继续在正文中编辑,两处不是同一个输入框。微软文档属性说明
- 选择“另存为”或“另存副本”,浏览到保存位置,将文件类型选为PDF。进入“更多选项 → 选项”,确认包含“文档属性”,再保存。Word导出PDF说明
- 打开新PDF,在阅读器的文档属性或描述面板里检查Title,再复制并搜索同一句“拍摄前确认本次交付需要的画面比例”。标题正确、文字却无法正常取得时,回源稿查是否把正文做成了截图;只有扫描原件则按上一节处理OCR与校对。
- 上传后,从网站实际下载链接重新取得一份文件,重复检查Title、这句话和版本。这样才能发现本地已经导出新版、公开链接却仍在给旧文件的情况。
如果只在电脑上重命名PDF,内部Title不会因此自动变成新名称。若回读仍是旧标题,先核源文档属性与导出选项,再核是否打开了正确的新文件,不必反复改下载按钮。
教学文件可以这样核对:
| 字段 | 教学值 | 它解决什么 |
|---|---|---|
| 页内标题 | 产品拍摄准备清单 | 打开后认清文件用途 |
| PDF Title | 产品拍摄准备清单|教学示例 | 文件属性不再带旧模板标题 |
| 文件名 | product-photo-preparation-checklist.pdf | 便于保存与维护 |
| 版本说明 | 教学版,2026-10-18 | 与后续更新区别 |
Google的历史PDF说明把文档标题元数据与指向文件的链接文字列为标题判断线索,但搜索结果仍可能自行生成标题。这里要确保信息准确,不是承诺某个Title会被逐字展示。
还要检查作者、主题等元数据是否意外保留了前客户、员工个人信息或旧品牌。不要为了SEO编造专家姓名、认证和机构,这些字段应与允许公开的真实资料一致。
手机打开以后,读者能不能用
PDF通常是固定版面。电脑上看起来整齐的三栏小字,到了手机可能要反复放大、横移,读者很快就找不到刚才那一行。
先在手机阅读器里实际试:从封面到关键步骤,能否看清正文、辨认图注、点击目录或网页链接。需要打印的清单可以保留适合打印的版式,同时在下载网页上提供核心摘要或HTML版本,让手机读者有选择。
图和文字分别承担任务
拍摄准备清单可以放示例画面比例,帮助摄影师理解横图、竖图与细节图的区别;“这次具体需要哪几个比例、各交多少张”,仍应保留为可读文字,不能全藏进一张海报。
压缩文件时,区分可压缩的装饰大图与需要看清的说明图。压到文件很小,却看不清标签、细节或图纸,不算完成优化。压缩后重新检查文字提取和关键图片,不只看文件大小。
在网页上把下载对象说清楚
不要在产品页只放一个“下载”按钮。它没有告诉客户下载什么、什么语言、适用哪个版本,也不方便后来维护者判断链接是否放错。
教学网页可以这样写:
下载《产品拍摄准备清单》教学版,包含画面比例、拍摄前资料与交付检查项目。PDF适合打印核对;如果只想快速阅读,先看本页摘要。版本日期:2026-10-18。
下面才是明确的文件链接。HTML形式可以是:
<a href="/downloads/product-photo-preparation-checklist.pdf">
  下载产品拍摄准备清单(PDF)
</a>
这是地址结构示例,发布时换成真实存在的文件。链接文字要符合文件实际内容,不能为了埋词把一份清单叫“完整产品摄影认证手册”。Google对可抓取链接与锚文本的说明也适用于这个入口。
若资料受权限限制,明确说明获取方式,不要让公开搜索进来的用户先看到“立即下载”,点击后才突然遇到无法申请的登录墙。敏感资料需要真实访问控制,SEO标签不承担保密功能。
上线核对的是文件,不是附件介绍页
WordPress媒体附件介绍页与原PDF文件是两个URL。介绍页标题正确,不代表PDF Title正确;介绍页能打开,也不代表真实文件没有404或登录限制。
从实际网页下载链接出发,检查以下对象:
- 原链接和最终地址:有没有跳到错误版本或临时存储地址。
- 文件响应:维护者核实际HTTP状态与Content-Type,确认取得PDF,不是一个返回200的HTML错误页。
- 文件本身:重新下载这次公开版本,核Title、正文文字、版本与图。
- 手机路径:未登录用户能按预期取得和阅读资料。
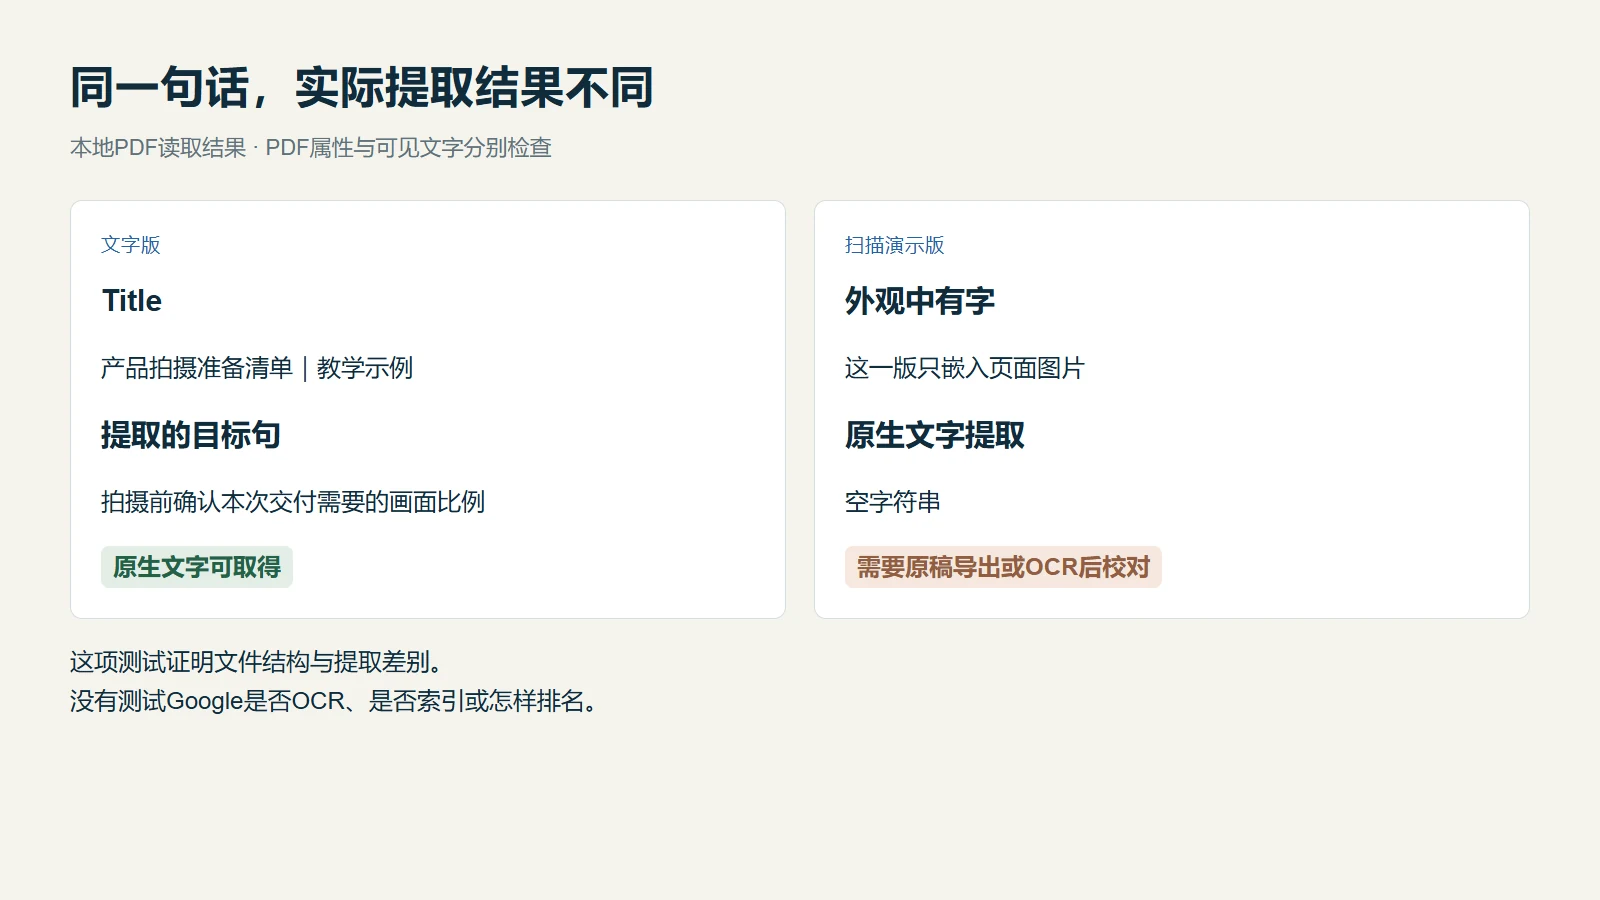
本地教学文件的检查结果,是带文字层版本能提取目标句、元数据Title与清单一致,图片版本没有可提取的原生正文。这证明演示文件的差别,不表示Google已抓取或索引它们。
如果文件由CDN发送,核公开链接取得的那一份,避免本地已改、线上缓存还在旧版。必要时按现有发布流程刷新受影响缓存,再重复这个文件的检查。
更新版本时,保留哪些旧入口
一份内容只是小幅修订,使用稳定URL替换可以减少旧链接失效,但应让读者辨认当前版本。若新旧版本适用对象不同,例如不同设备年代的手册,通常需要清楚保留版本关系,而不是直接覆盖唯一旧文件。
更新时同时检查下载页、正文引用、目录、邮件和外部常用链接。把“最新文件已上传”写进任务完成记录之前,至少从一个现有入口实际下载一次。
如果内容已迁到完整网页、PDF不再适合作为独立搜索落点,再回到PDF保留与规范化决策处理。不要为了维护省事,给全站所有PDF统一禁止索引,误伤仍有独立用途的资料。
最后回到Google,查这一个文件的状态
把真实PDF完整URL放进GSC网址检查,查看它自身的记录。产品网页已收录,不等于其PDF已收录;同样,搜索中出现PDF,也不等于网页被它替代。
文件没有被发现,先核站内真实链接与抓取条件。已经抓到但未索引,再查文件用途、内容、规范关系与实际报告。查看查询表现时,也按文件URL区分,不把整站平均位置当成这个文件的表现。
PDF优化最终应让客户取得正确、可读、可维护的资料。网站整体的文件与页面路径,可从谷歌SEO学习路径继续;文件很多、版本关系混乱时,先整理代表文件和对应网页,再安排批量修改。
继续阅读:谷歌SEO完整优化流程:把内容研究、页面优化与上线复查连起来。
常见问题
扫描PDF看得很清楚,就不需要文字层了吗?
不能仅凭外观判断。尝试复制和搜索关键句;有OCR文字层也要核关键字段与顺序。原稿可用时,优先保留准确文字导出。
只改文件名,会改变PDF内部标题吗?
通常不会同步修改内部元数据。应在文档属性或源文档中设置,再重新导出并核对公开下载的PDF。
所有PDF都需要改成网页吗?
不需要。打印、离线和手册用途可以保留PDF;交互、选型和经常变化的信息可由网页承接。按用户任务分配,并处理重复与版本关系。